python抓取某汽车网数据解析html存入excel示例
1、某汽车网站地址
2、使用firefox查看后发现,此网站的信息未使用json数据,而是简单那的html页面而已
3、使用pyquery库中的PyQuery进行html的解析
页面样式: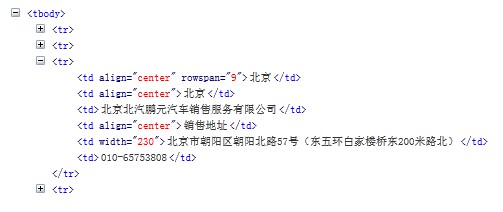
复制代码 代码如下:
def get_dealer_info(self):
"""获取经销商信息"""
css_select = 'html body div.box div.news_wrapper div.main div.news_list div.service_main div table tr '
#使用火狐浏览器中的自动复制css路径得到需要位置数据
page = urllib2.urlopen(self.entry_url).read()
#读取页面
page = page.replace('<br />','&')
page = page.replace('<br/>','&')
#由于页面中的电话信息中使用了br换行,所以在抓取的时候会产生问题
#问题是:如果取得一对标签中的数据,中包含<br/>,会出现值得到br之前的数据,而后的数据将得不到,原因个人认为是解析html是会任务/>结尾标准
d = pq(page)
#使用PyQuery解析页面,此处pq=PyQuery,因为from pyquery import PyQuery as pq
dealer_list = []
#创建列表用于提交到存储方法
for dealer_div in d(css_select):
#此处定位tr,具体数据在此标签中的td标签内
p = dealer_div.findall('td')
#此处p就是一个tr标签内,全部td数据的集合
dealer = {}
#此处的字典用于存储一个店铺的信息用于提交到列表中
if len(p)==1:
#此处多哥if判断是用于对数据进行处理,因为一些格式不符合最终数据的要求,需要剔除,这个快的代码按需求而定
print '@'
elif len(p)==6 :
strp = p[0].text.strip()
dealer[Constant.CITY] = p[1].text.strip()
strc = p[2].text.strip()
dealer[Constant.PROVINCE] = p[0].text.strip()
dealer[Constant.CITY] = p[1].text.strip()
dealer[Constant.NAME] = p[2].text.strip()
dealer[Constant.ADDRESSTYPE] = p[3].text.strip()
dealer[Constant.ADDRESS] = p[4].text.strip()
dealer[Constant.TELPHONE] = p[5].text.strip()
dealer_list.append(dealer)
elif len(p)==5:
if p[0].text.strip() != u'省份':
dealer[Constant.PROVINCE] = strp
dealer[Constant.CITY] = p[0].text.strip()
dealer[Constant.NAME] = p[1].text.strip()
dealer[Constant.ADDRESSTYPE] = p[2].text.strip()
dealer[Constant.ADDRESS] = p[3].text.strip()
dealer[Constant.TELPHONE] = p[4].text.strip()
dealer_list.append(dealer)
elif len(p)==3:
print '@@'
print '@@@'
self.saver.add(dealer_list)
self.saver.commit()
4、最终代码执行成功,得到了相应数据并存入excel中