python2爬取百度贴吧指定关键字和图片代码实例
目的:在百度贴吧输入关键字和要查找的起始结束页,获取帖子里面楼主所发的图片
思路:
- 获取分页里面的帖子链接列表
- 获取帖子里面楼主所发的图片链接列表
- 保存图片到本地
注意事项:
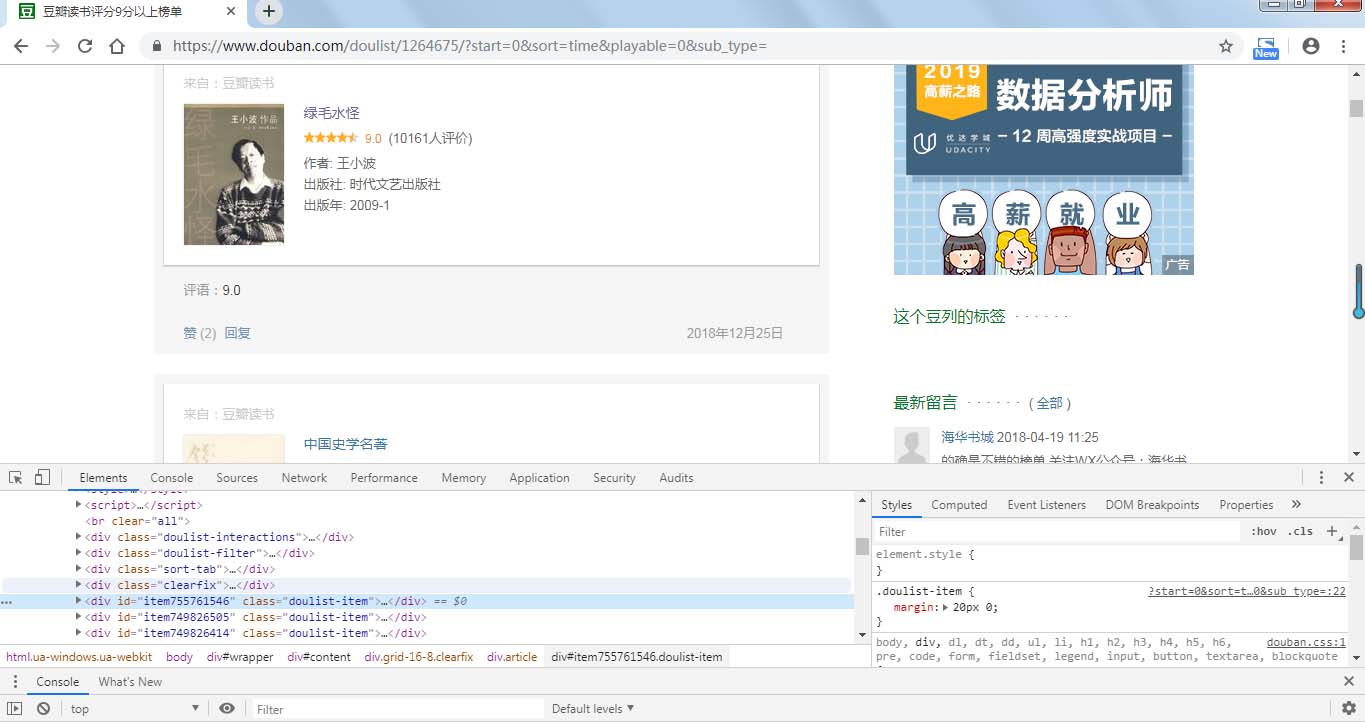
- 问题:在谷歌浏览器使用xpath helper插件时有匹配结果,但在程序里面使用python内带的xpath匹配却为空的原因。
- 原因:不同服务器会对不同的浏览器返回不同的数据,导致在谷歌浏览器看到的和服务器返回的有区别
- 解决方法:使用IE浏览器的User-agenet,而且越老的版本,报错几率相对越小
#!/usr/bin/env python
# -*- coding:utf-8 -*-
import urllib2
import urllib
import os
from lxml import etree
keyword = raw_input('请输入要查询的关键字: ')

keyword = {'kw':keyword}

kw = urllib.urlencode(keyword)

startpage = raw_input('请输入开始页数: ')

endpage = raw_input('请输入结束页数: ')

url = 'https://tieba.baidu.com/f' + '?' + kw

print('开始下载...')
# 计算下载的图片个数,注意:变量n如放在最外层循环,可以统计每个分页图片个数
n = 0
# 获取分页里面帖子链接列表,获取每个帖子里楼主所发的图片链接列表,保存图片
# 获取帖子链接列表
for page in range(int(startpage),int(endpage)+1):
    pnumber = {'pn': str((page - 1)*50)}
    pnumber = urllib.urlencode(pnumber)
    fullurl = url + '&' + pnumber
    # 发现使用谷歌浏览器的User-Agent,会导致后面的xpath匹配结果有时为空。原因:服务器会对不同的浏览器发出的同一请求返回不同格式的数据,此时返回的数据和在谷歌浏览器里面看到的数据不同。
    # 解决办法:使用IE浏览器的User-Agent,因为IE的相对来说更标准,而且版本越老问题越少。
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko"}
    request = urllib2.Request(fullurl,headers=headers)
    response = urllib2.urlopen(request)
    html = response.read()

    # 解析html 为 HTML DOM文档
    content = etree.HTML(html)
    # xpath使用下面括号内容进行匹配,使用a的属性使用了class='j_th_tit'去过滤广告则匹配结果为空;换成a的属性rel="noreferrer"就解决。为啥换不清楚。思路,这个属性不行换个属性。
    # 获取每个分页里面的帖子的链接列表
    link_list = content.xpath('//div[@class="threadlist_lz clearfix"]/div/a[@rel="noreferrer"]/@href')
    # 获取该帖子楼主所发的图片链接列表
    for link in link_list:
      link = 'https://tieba.baidu.com' + link
      request2 = urllib2.Request(link,headers=headers)
      response2 = urllib2.urlopen(request2)
      html2 = response2.read()

      # 把html字符串解析为html dom
      content2 = etree.HTML(html2)

      # 使用xpath匹配其里面层主所发的图片的链接
      link_list2 = content2.xpath('//img[@class="BDE_Image"]/@src')

      # 遍历图片链接列表,保存图片到文件夹images内
      for link2 in link_list2:

        request3 = urllib2.Request(link2,headers=headers)
        response3 = urllib2.urlopen(request3)
        html3 = response3.read()
        # 指定文件名
        filename = link2[-10:]
        n += 1
        print('正在保存第 %3d 张图片'%n)

        # html3为返回的图片内容,把图片写入images2文件夹内
        with open('images' + '/' + filename,'wb') as f:
          f.write(html3)

print('下载结束!')
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。