Python打印scrapy蜘蛛抓取树结构的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了Python打印scrapy蜘蛛抓取树结构的方法。分享给大家供大家参考。具体如下:

通过下面这段代码可以一目了然的知道scrapy的抓取页面结构,调用也非常简单

#!/usr/bin/env python
import fileinput, re
from collections import defaultdict
def print_urls(allurls, referer, indent=0):
  urls = allurls[referer]
  for url in urls:
    print ' '*indent + referer
    if url in allurls:
      print_urls(allurls, url, indent+2)
def main():
  log_re = re.compile(r'<GET (.*?)> \(referer: (.*?)\)')
  allurls = defaultdict(list)
  for l in fileinput.input():
    m = log_re.search(l)
    if m:
      url, ref = m.groups()
      allurls[ref] += [url]
  print_urls(allurls, 'None')
main()

希望本文所述对大家的Python程序设计有所帮助。
相关文章

python爬虫正则表达式之处理换行符

刚开始学python,记录下问题。 代码如下: #coding:utf-8 import re,urllib2 def getHTML(url): html=urllib2.ur...

python爬虫爬取快手视频多线程下载功能

python爬虫爬取快手视频多线程下载功能

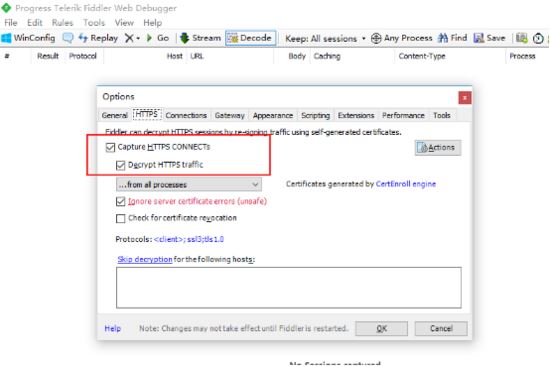
环境: python 2.7 + win10 工具:fiddler postman 安卓模拟器 首先,打开fiddler,fiddler作为http/https 抓包神器,这里就不多介绍...

Python抓取百度查询结果的方法

本文实例讲述了Python抓取百度查询结果的方法。分享给大家供大家参考。具体实现方法如下: #win python 2.7.x import re,sys,urllib,codecs...

Python实现的爬取网易动态评论操作示例

Python实现的爬取网易动态评论操作示例

本文实例讲述了Python实现的爬取网易动态评论操作。分享给大家供大家参考,具体如下: 打开网易的一条新闻的源代码后,发现并没有所要得评论内容。 经过学习后发现,源代码只是一个完整页面的...

python 爬取学信网登录页面的例子

python 爬取学信网登录页面的例子

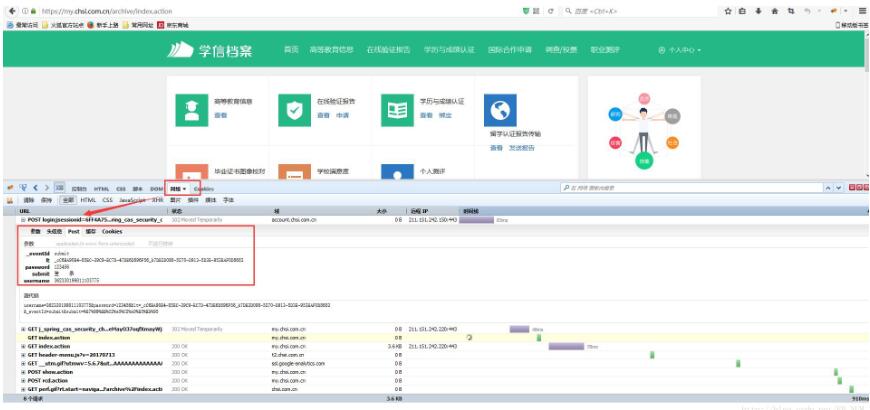
我们以学信网为例爬取个人信息 **如果看不清楚 按照以下步骤:** 1.火狐为例 打开需要登录的网页–> F12 开发者模式 (鼠标右击,点击检查元素)–点击网络 –>需要...