python利用selenium进行浏览器爬虫

yipeiwu_com7年前Python爬虫

前言

相信大家刚开始在做爬虫的时候,是不是requests和sound这两个库来使用,这样确实有助于我们学习爬虫的知识点,下面来介绍一个算事较复杂的爬虫案例selenium进形打开浏览器爬取网站的信息

导入第三方库

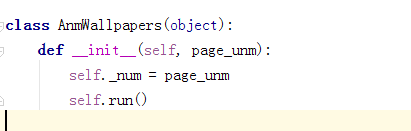
自执行函数

解析信息


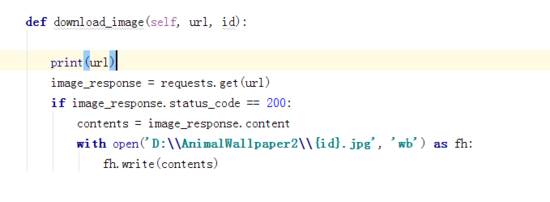
保存文件信息

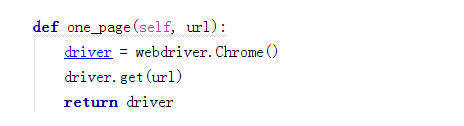
打开浏览器

获取链接信息
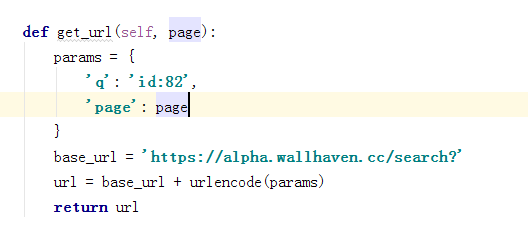

执行函数
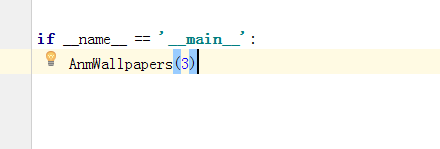

运行结果

总结

以上所述是小编给大家介绍的python利用selenium进行浏览器爬虫,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!
如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
相关文章

python爬虫项目设置一个中断重连的程序的实现

做爬虫项目时,我们需要考虑一个爬虫在爬取时会遇到各种情况(网站验证,ip封禁),导致爬虫程序中断,这时我们已经爬取过一些数据,再次爬取时这些数据就可以忽略,所以我们需要在爬虫项目中设置一...

实践Python的爬虫框架Scrapy来抓取豆瓣电影TOP250

实践Python的爬虫框架Scrapy来抓取豆瓣电影TOP250

安装部署Scrapy 在安装Scrapy前首先需要确定的是已经安装好了Python(目前Scrapy支持Python2.5,Python2.6和Python2.7)。官方文档中介绍了三种...

Python爬虫之pandas基本安装与使用方法示例

本文实例讲述了Python爬虫之pandas基本安装与使用方法。分享给大家供大家参考,具体如下: 一、简介: Python Data Analysis Library 或 pandas...

python网络爬虫 CrawlSpider使用详解

CrawlSpider 作用:用于进行全站数据爬取 CrawlSpider就是Spider的一个子类 如何新建一个基于CrawlSpider的爬虫文件 sc...

python爬虫selenium和phantomJs使用方法解析

python爬虫selenium和phantomJs使用方法解析

1.selenum:三方库。可以实现让浏览器完成自动化的操作。 2.环境搭建 2.1 安装: pip install selenium 2.2 获取浏览器的驱动程序 下载地址...