如何爬取通过ajax加载数据的网站
目前很多网站都使用ajax技术动态加载数据,和常规的网站不一样,数据时动态加载的,如果我们使用常规的方法爬取网页,得到的只是一堆html代码,没有任何的数据。
请看下面的代码:
url = 'https://www.toutiao.com/search/?keyword=美女'
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0"}

response = requests.get(url,headers=headers)
print(response.text)
上面的代码是爬取今日头条的一个网页,并打印出get方法返回的文本内容如下图所示,值现在一堆网页代码,并没有相关的头条新闻信息
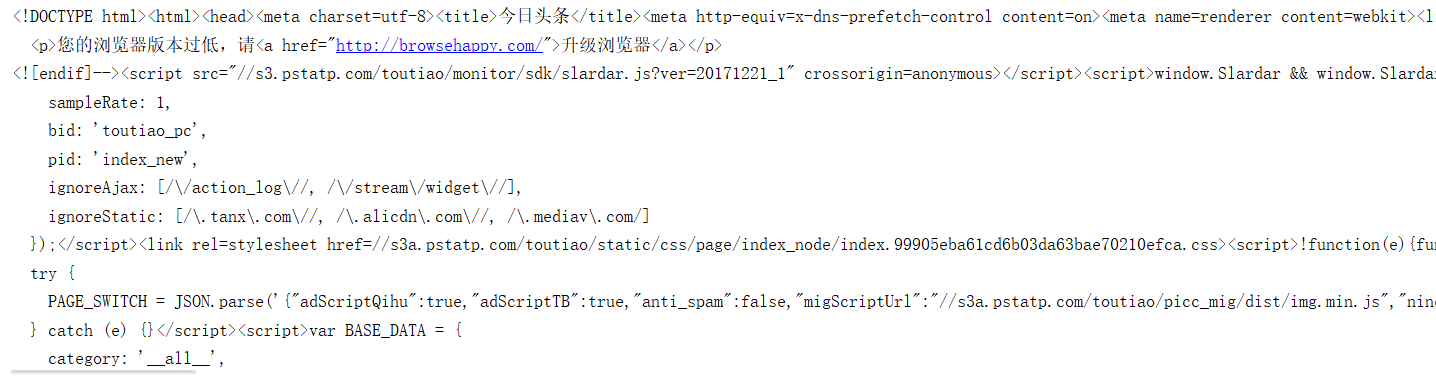
内容过多,只截取部分内容,有兴趣的朋友可以执行上面的代码看下效果。
对于使用ajax动态加载数据的网页要怎么爬取呢?我们先看下近日头条是如何使用ajax加载数据的。通过chrome的开发者工具来看数据加载过程。
首先打开chrome浏览器,打开开发者工具,点击Network选项,点击XHR选项,然后输入网址:https://www.toutiao.com/search/?keyword=美女 ,点击Preview选项卡,就会看到通过ajax请求返回的数据,Name那一栏就是ajax请求,当鼠标向下滑动时,就会出现多条ajax请求:
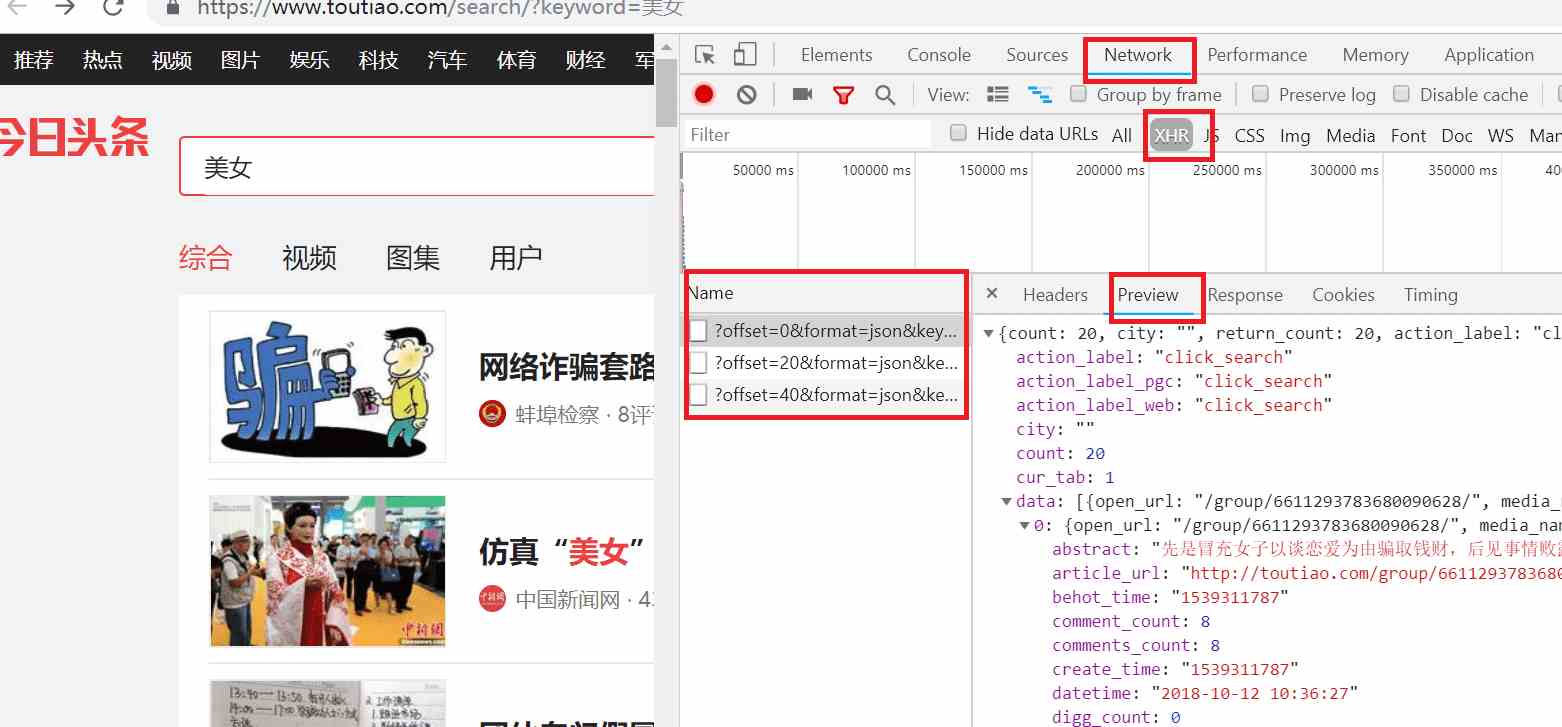
通过上图我们知道ajax请求返回的是json数据,我们继续分析ajax请求返回的json数据,点击data展开数据,接着点击0展开数据,发现有个title字段,内容刚好和网页的第一条数据匹配,可知这就是我们要爬取的数据。如下所示:

鼠标向下滚动到网页底部时就会触发一次ajax请求,下面是三次ajax请求:
观察每个ajax请求,发现每个ajax请求都有offset,format,keyword,autoload,count,cur_tab,from,pd参数,除了offset参数有变化之外,其他的都不变化。每次ajax请求offset的参数变化规律是0,20,40,60…,可以推测offset是偏移量,count参数是一次ajax请求返回数据的条数。
为了防止爬虫被封,每次请求时要把请求时都要传递请求头信息,请求头信息中包含了浏览器的信息,如果请求没有浏览器信息,就认为是网络爬虫,直接拒绝访问。request header信息如下:
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0",
"referer": "https://www.toutiao.com/search/?keyword=%E7%BE%8E%E5%A5%B3",
'x-requested-with': 'XMLHttpRequest'
}
完整代码如下:
import requests
from urllib.parse import urlencode

def parse_ajax_web(offset):
  url = 'https://www.toutiao.com/search_content/?'
  #请求头信息
  headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0",
    "referer": "https://www.toutiao.com/search/",
    'x-requested-with': 'XMLHttpRequest'
  }
  #每个ajax请求要传递的参数
  parm = {
    'offset': offset,
    'format': 'json',
    'keyword': '美女',
    'autoload': 'true',
    'count': 20,
    'cur_tab': 1,
    'from': 'search_tab',
    'pd': 'synthesis'
  }
  #构造ajax请求url
  ajax_url = url + urlencode(parm)
  #调用ajax请求
  response = requests.get(ajax_url, headers=headers)
  #ajax请求返回的是json数据,通过调用json()方法得到json数据
  json = response.json()
  data = json.get('data')
  for item in data:
    if item.get('title') is not None:
      print(item.get('title'))

def main():
  #调用ajax的次数,这里调用5次。
  for offset in (range(0,5)):
    parse_ajax_web(offset*20)

if __name__ == '__main__':
  main()
上面是爬取通过ajax请求加载数据网站的例子,如果想要其他的数据,可以动手自己写,这里只是搭了一个架子,各位可以尝试将数据写入到excel或者数据库中。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。