python使用正则表达式提取网页URL的方法

yipeiwu_com7年前Python基础

本文实例讲述了python使用正则表达式提取网页URL的方法。分享给大家供大家参考。具体实现方法如下:

import re
import urllib
url="//www.jb51.net"
s=urllib.urlopen(url).read()
ss=s.replace(" ","")
urls=re.findall(r"<a.*?href=.*?<\/a>",ss,re.I)
for i in urls:
 print i
else:
 print 'this is over'

PS:这里再为大家提供2款非常方便的正则表达式工具供大家参考使用:

JavaScript正则表达式在线测试工具:
http://tools.jb51.net/regex/javascript

正则表达式在线生成工具:
http://tools.jb51.net/regex/create_reg

希望本文所述对大家的Python程序设计有所帮助。
相关文章

python读取dicom图像示例(SimpleITK和dicom包实现)

1. 用SimpleITK读取dicom序列: import SimpleITK as sitk import numpy as np img_path='F:\\dataset\\...

python计算二维矩形IOU实例

python计算二维矩形IOU实例

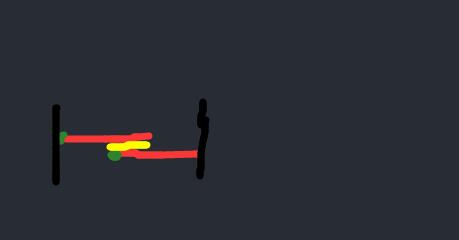
计算交并比:交的面积除以并的面积。 要求矩形框的长和宽应该平行于图片框。不然不能用这样的公式计算。 原理,从一维上来理解:两条红线的距离之和减去黑色线之间的距离就是相交的距离。两条红线之...

Python中str.join()简单用法示例

本文实例讲述了Python中str.join()简单用法。分享给大家供大家参考,具体如下: Python join() 方法用于将序列中的元素以指定的字符连接生成一个新的字符串。其中,序...

浅谈pandas中Dataframe的查询方法([], loc, iloc, at, iat, ix)

pandas为我们提供了多种切片方法,而要是不太了解这些方法,就会经常容易混淆。下面举例对这些切片方法进行说明。 数据介绍 先随机生成一组数据: In [5]: rnd_1 = [r...

简单解决Python文件中文编码问题

简单解决Python文件中文编码问题

读写中文 需要读取utf-8编码的中文文件,先利用sublime text软件将它改成无DOM的编码,然后用以下代码: with codecs.open(note_path, 'r+...