python使用自定义user-agent抓取网页的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了python使用自定义user-agent抓取网页的方法。分享给大家供大家参考。具体如下:

下面python代码通过urllib2抓取指定的url的内容,并且使用自定义的user-agent,可防止网站屏蔽采集器

import urllib2
req = urllib2.Request('http://192.168.1.2/')
req.add_header('User-agent', 'Mozilla 5.10')
res = urllib2.urlopen(req)
html = res.read()

希望本文所述对大家的Python程序设计有所帮助。
相关文章

利用PyCharm Profile分析异步爬虫效率详解

利用PyCharm Profile分析异步爬虫效率详解

今天比较忙,水一下 下面的代码来源于这个视频里面提到的,github 的链接为:github.com/mikeckenned…(本地下载) 第一个代码如下,就是一个普通的 for 循环...

Python 制作糗事百科爬虫实例

Python 制作糗事百科爬虫实例

早上起来闲来无事做,莫名其妙的就弹出了糗事百科的段子,转念一想既然你送上门来,那我就写个爬虫到你网站上爬一爬吧,一来当做练练手,二来也算找点乐子。 其实这两天也正在接触数据库的内容,可以...

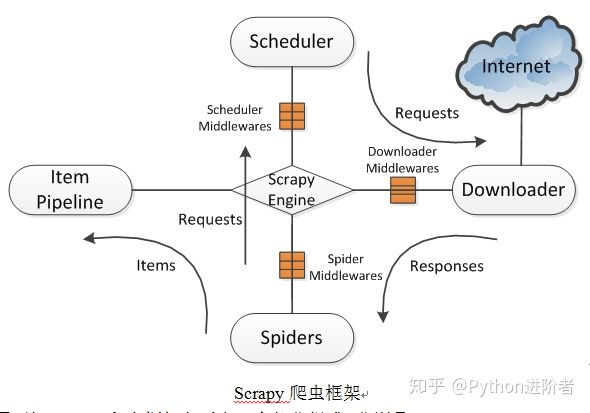
浅谈Scrapy网络爬虫框架的工作原理和数据采集

浅谈Scrapy网络爬虫框架的工作原理和数据采集

今天小编给大家详细的讲解一下Scrapy爬虫框架,希望对大家的学习有帮助。 1、Scrapy爬虫框架 Scrapy是一个使用Python编程语言编写的爬虫框架,任何人都可以根据自己的需求...

详解python3 + Scrapy爬虫学习之创建项目

详解python3 + Scrapy爬虫学习之创建项目

最近准备做一个关于scrapy框架的实战,爬取腾讯社招信息并存储,这篇博客记录一下创建项目的步骤 pycharm是无法创建一个scrapy项目的 因此,我们需要用命令行的方法新建一个s...

Python Request爬取seo.chinaz.com百度权重网站的查询结果过程解析

Python Request爬取seo.chinaz.com百度权重网站的查询结果过程解析

一:脚本需求 利用Python3查询网站权重并自动存储在本地数据库(Mysql数据库)中,同时导出一份网站权重查询结果的EXCEL表格 数据库类型:MySql 数据库表单名称:webs...