python爬虫实现教程转换成 PDF 电子书
写爬虫似乎没有比用 Python 更合适了,Python 社区提供的爬虫工具多得让你眼花缭乱,各种拿来就可以直接用的 library 分分钟就可以写出一个爬虫出来,今天就琢磨着写一个爬虫,将廖雪峰的 Python 教程 爬下来做成 PDF 电子书方便大家离线阅读。
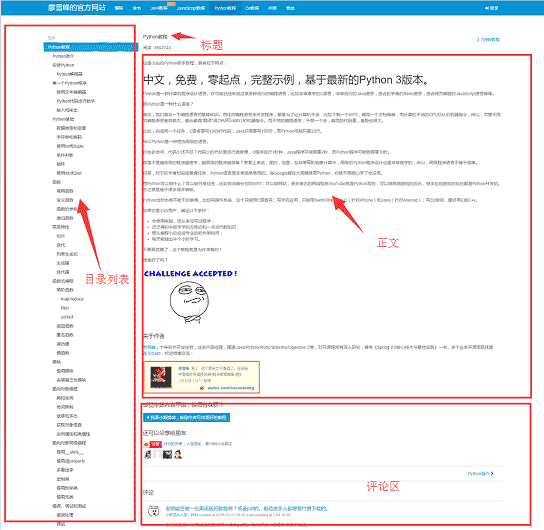
开始写爬虫前,我们先来分析一下该网站1的页面结构,网页的左侧是教程的目录大纲,每个 URL 对应到右边的一篇文章,右侧上方是文章的标题,中间是文章的正文部分,正文内容是我们关心的重点,我们要爬的数据就是所有网页的正文部分,下方是用户的评论区,评论区对我们没什么用,所以可以忽略它。
工具准备
弄清楚了网站的基本结构后就可以开始准备爬虫所依赖的工具包了。requests、beautifulsoup 是爬虫两大神器,reuqests 用于网络请求,beautifusoup 用于操作 html 数据。有了这两把梭子,干起活来利索,scrapy 这样的爬虫框架我们就不用了,小程序派上它有点杀鸡用牛刀的意思。此外,既然是把 html 文件转为 pdf,那么也要有相应的库支持, wkhtmltopdf 就是一个非常好的工具,它可以用适用于多平台的 html 到 pdf 的转换,pdfkit 是 wkhtmltopdf 的Python封装包。首先安装好下面的依赖包,
接着安装 wkhtmltopdf
pip install requests
pip install beautifulsoup
pip install pdfkit
安装 wkhtmltopdf
Windows平台直接在 wkhtmltopdf 官网2下载稳定版的进行安装,安装完成之后把该程序的执行路径加入到系统环境 $PATH 变量中,否则 pdfkit 找不到 wkhtmltopdf 就出现错误 “No wkhtmltopdf executable found”。Ubuntu 和 CentOS 可以直接用命令行进行安装
$ sudo apt-get install wkhtmltopdf # ubuntu
$ sudo yum intsall wkhtmltopdf   # centos
爬虫实现
一切准备就绪后就可以上代码了,不过写代码之前还是先整理一下思绪。程序的目的是要把所有 URL 对应的 html 正文部分保存到本地,然后利用 pdfkit 把这些文件转换成一个 pdf 文件。我们把任务拆分一下,首先是把某一个 URL 对应的 html 正文保存到本地,然后找到所有的 URL 执行相同的操作。
用 Chrome 浏览器找到页面正文部分的标签,按 F12 找到正文对应的 div 标签: <div >,该 div 是网页的正文内容。用 requests 把整个页面加载到本地后,就可以使用 beautifulsoup 操作 HTML 的 dom 元素 来提取正文内容了。
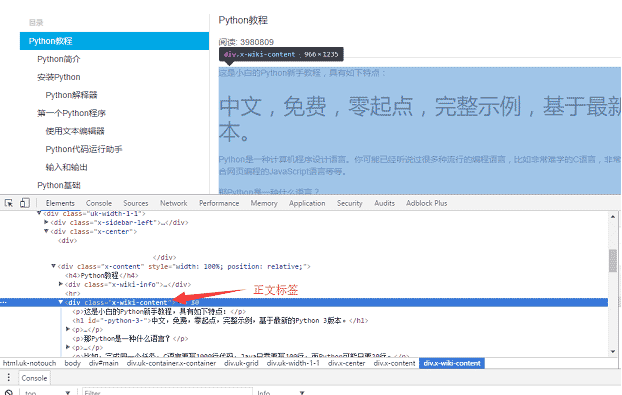
具体的实现代码如下:用 soup.find_all 函数找到正文标签,然后把正文部分的内容保存到 a.html 文件中。
def parse_url_to_html(url):
  response = requests.get(url)
  soup = BeautifulSoup(response.content, "html5lib")
  body = soup.find_all(class_="x-wiki-content")[0]
  html = str(body)
  with open("a.html", 'wb') as f:
    f.write(html)
第二步就是把页面左侧所有 URL 解析出来。采用同样的方式,找到 左侧菜单标签 <ul >
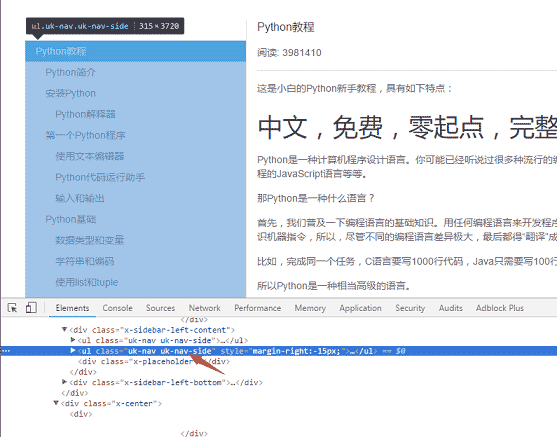
具体代码实现逻辑:因为页面上有两个uk-nav uk-nav-side的 class 属性,而真正的目录列表是第二个。所有的 url 获取了,url 转 html 的函数在第一步也写好了。
def get_url_list():
  """
  获取所有URL目录列表
  """
  response = requests.get("http://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000")
  soup = BeautifulSoup(response.content, "html5lib")
  menu_tag = soup.find_all(class_="uk-nav uk-nav-side")[1]
  urls = []
  for li in menu_tag.find_all("li"):
    url = "http://www.liaoxuefeng.com" + li.a.get('href')
    urls.append(url)
  return urls
最后一步就是把 html 转换成pdf文件了。转换成 pdf 文件非常简单,因为 pdfkit 把所有的逻辑都封装好了,你只需要调用函数 pdfkit.from_file
def save_pdf(htmls):
  """
  把所有html文件转换成pdf文件
  """
  options = {
    'page-size': 'Letter',
    'encoding': "UTF-8",
    'custom-header': [
      ('Accept-Encoding', 'gzip')
    ]
  }
  pdfkit.from_file(htmls, file_name, options=options)
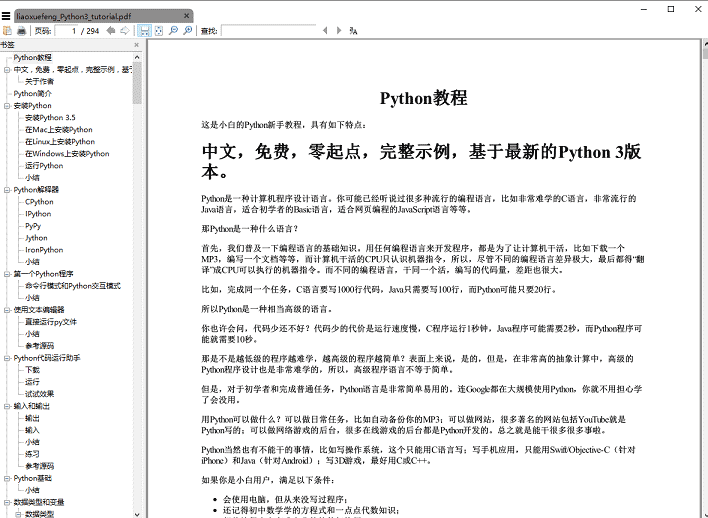
执行 save_pdf 函数,电子书 pdf 文件就生成了,效果图:
总结
总共代码量加起来不到50行,不过,且慢,其实上面给出的代码省略了一些细节,比如,如何获取文章的标题,正文内容的 img 标签使用的是相对路径,如果要想在 pdf 中正常显示图片就需要将相对路径改为绝对路径,还有保存下来的 html 临时文件都要删除,这些细节末叶都放在github上。
完整代码可以上github下载 ,代码在 Windows 平台亲测有效,欢迎 fork 下载自己改进。github 地址3,GitHub访问不了的同学可以用码云4, 《廖雪峰的 Python 教程》电子书 PDF 文件可以通过关注本公众号『一个程序员的微站』回复 “pdf” 免费下载阅读。