Python实现的爬虫刷回复功能示例
本文实例讲述了Python实现的爬虫刷回复功能。分享给大家供大家参考,具体如下:
最近闲的无聊,就想着去看看爬虫,顺着爬虫顺利的做到了模拟登录、刷帖子等等,这里简要说一下。
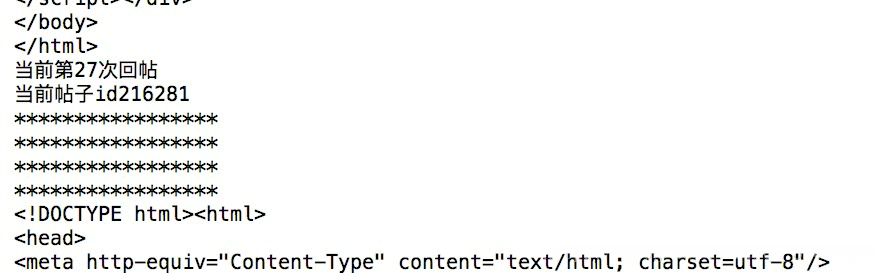
使用Python2.7写的爬虫,对某论坛做模拟登陆和刷帖子、回复等等,由于之前是没有接触过爬虫,这次之后感觉爬虫很强大,能做很多事,先来贴几张图。
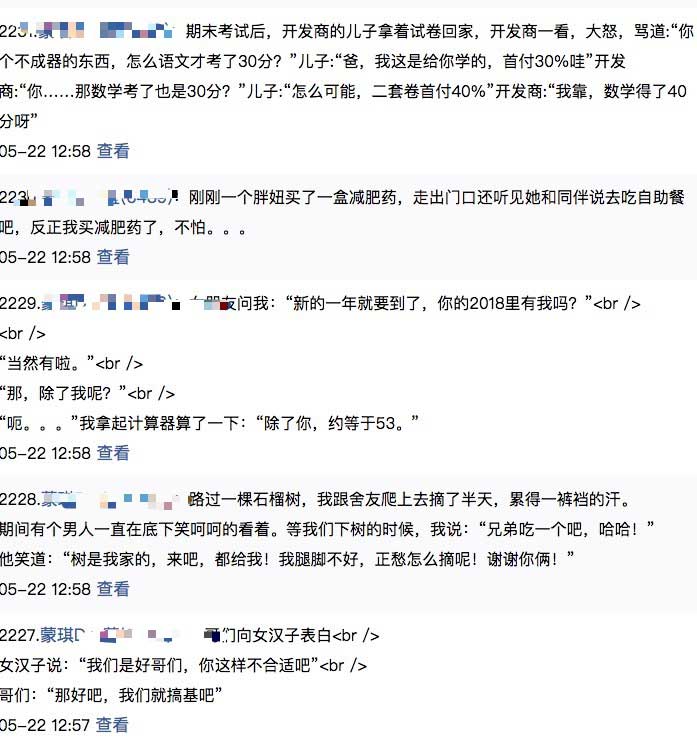
由于论坛不让使用相同的文字,所以调用了笑话的api,达到不同文字的目的。
该论坛使用的是cookie,所以先去获取一下cookie,顺便将cookie写到文件里面。
'''
获取cookie
'''
def get_cookie(login_data, url, testurl=None):
  filename = "cookie"
  cookie = cookielib.MozillaCookieJar(filename)
  hadler = urllib2.HTTPCookieProcessor(cookie)
  opener = urllib2.build_opener(hadler)
  post_data = urllib.urlencode(
    {'logname': 123456, "logpass": "123456", "action": "login", })
  url = 'http://*****.me/waplogin.aspx'
  opener.open(url, post_data)
  cookie.save(ignore_discard=True, ignore_expires=True)
  print("获取成功")
  # print(opener.open(testurl).read())
先要分析该网站登录地址,登录需要的参数,如上代码
获得cookie之后,分析该论坛的回复参数,该论坛采用的是post提交,需要有帖子id,回复内容等等,分析之后得到如下代码
代码先加载文件里面的cookie,然后调用了haha这个笑话api,当然我已经将这个api的json进行了处理,这里只要笑话内容就行。
'''
回复帖子
'''
def post_reply():
  filename = "cookie"
  cookie = cookielib.MozillaCookieJar(filename)
  cookie.load(filename, ignore_discard=True, ignore_expires=True)
  handler = urllib2.HTTPCookieProcessor(cookie)
  opener = urllib2.build_opener(handler)
  num=0
  for i in range(216255, 800000):
    num = num + 1
    huifu = urllib.urlencode(
      {'sendmsg': 0, "content": str(haha(num)), "action": "add", "id": str(i), "classid": 177})
    gradeUrl = 'http://******.me/bbs/book_re.aspx'
    result = opener.open(gradeUrl)
    print result.read()
    print "当前第" + str(num) + "" + "次回帖"
    print("当前帖子id" + str(i))
    sleep(1)
发帖子代码:
'''
发帖子(普通帖子或者加悬赏分的帖子:并不是悬赏板块的帖子)
'''
def post_articles(book_title, book_content, classid=177, sendmoney=0):
  filename = "cookie"
  cookie = cookielib.MozillaCookieJar(filename)
  cookie.load(filename, ignore_discard=True, ignore_expires=True)
  handler = urllib2.HTTPCookieProcessor(cookie)
  opener = urllib2.build_opener(handler)
  post_articles = urllib.urlencode(
    {'sendmsg': 0, "book_title": str(book_title), "action": "gomod", "siteid": "1000",
     "book_content": str(book_content), "classid": classid, "sendmoney": sendmoney})
  gradeUrl = 'http://*****.me/bbs/book_view_add.aspx'
  result = opener.open(gradeUrl, post_articles)
  print(result.read())
将这些代码进行进行调用就可以去刷回复了。
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。