python爬虫解决验证码的思路及示例
如果直接从生成验证码的页面把验证码下载到本地后识别,再构造表单数据发送的话,会有一个验证码同步的问题,即请求了两次验证码,而识别出来的验证码并不是实际需要发送的验证码。有如下几种方法解决。
法1:
用session:
mysession = requests.Session()
login_url = 'http://xxx.com'
checkcode_url='http://yyy.com'
html = mysession.get(login_url,timeout=60*4)
#....balabala解析操作....
checkcode = mysession.get(checkcode_url,timeout=60*4)
with open('checkcode.png','wb') as f:
  f.write(checkcode.content)

#接下来balabala对图像操作,可以用python的相关库(识别率低,教务网的验证码都够呛),也可以用云速等第三方验证码识别网站提供的有偿服务(识别度较高)

#再接下来构造表单数据balabala
法2:
用cookie:
#绑定cookie
checkcode_url='http://yyy.com'
cookie = cookielib.CookieJar()
handler = urllib2.HTTPCookieProcessor(cookie)
opener = urllib2.build_opener(handler)

#先读取验证码的url
picture = opener.open(checkcode_url).read()

#balabala图像处理

# 生成post数据
data = urllib.urlencode(postData)
# 构造request请求
request = urllib2.Request(PostUrl, data, headers)
# 利用之前存有cookie的opener登录页面
try:
  response = opener.open(request)
  result = response.read()
except urllib2.HTTPError, e:
  print e.code
法3:
selenium+手动构造cookie: 该方法无需识别验证码,本人尚未尝试。
webdriver 操作 cookie 的方法有:
- get_cookies() 获得所有 cookie 信息
- get_cookie(name) 返回特定 name 有 cookie 信息
- add_cookie(cookie_dict) 添加 cookie,必须有 name 和 value 值
- delete_cookie(name) 删除特定(部分)的 cookie 信息
- delete_all_cookies() 删除所有 cookie 信息
....
#第一次访问 xxx 网站
driver.get("http://xxx.com")
#将用户名密码写入浏览器 cookie
driver.add_cookie({'name':'username','value':'username'})
driver.add_cookie({'name':'password','value':'password'})
#再次访问 xxx 网站,将会自动登录
driver.get("http://xxx.com")
time.sleep(5)
....
driver.quit()
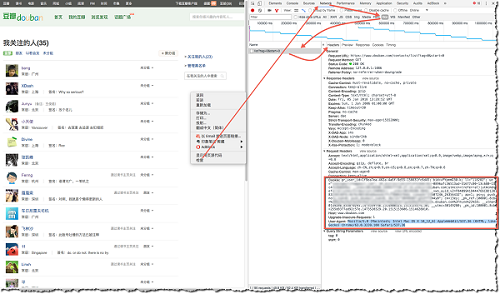
这种方法难点在于确定该网站是用cookie中的什么key值来表示“用户名”和“密码”的。而且好像有些cookie是加密过的。可以先用get_cookies()进行观察。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。