Python3实现爬虫爬取赶集网列表功能【基于request和BeautifulSoup模块】
本文实例讲述了Python3实现爬虫爬取赶集网列表功能。分享给大家供大家参考,具体如下:
python3爬虫之爬取赶集网列表。这几天一直在学习使用python3爬取数据,今天记录一下,代码很简单很容易上手。
首先需要安装python3。如果还没有安装,可参考本站前面关于python3安装与配置相关文章。
首先需要安装request和BeautifulSoup两个模块
request是Python的HTTP网络请求模块,使用Requests可以轻而易举的完成浏览器可有的任何操作
pip install requests
BeautifulSoup是用Python写的一个HTML/XML的解析器,它可以很好的处理不规范标记并生成剖析树
pip install beautifulsoup4
代码:
from urllib import request
from bs4 import BeautifulSoup
#构造头文件,模拟浏览器访问
url="http://xa.ganji.com/meirdjm/o2/"
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36'}
page = request.Request(url,headers=headers)
# 发送请求,获取内容
page_info = request.urlopen(page).read().decode('utf-8')
# 将获取到的内容转换成BeautifulSoup格式,并将html.parser作为解析器
soup = BeautifulSoup(page_info, 'html.parser')
# 查找所有a标签中class='list-info-title'
titles = soup.find_all('a',class_="list-info-title")
# 打印抓取到的title
for title in titles:
 print(title.string)
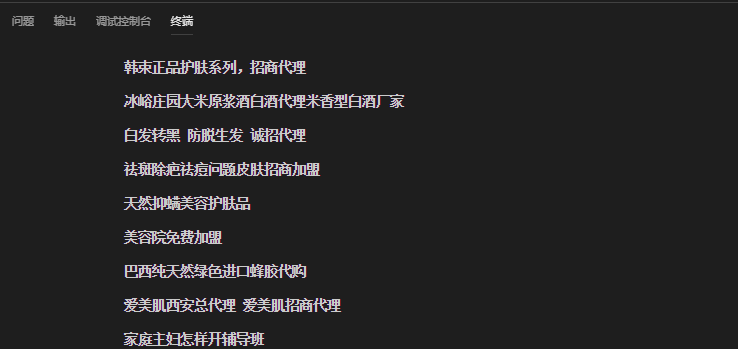
结果:
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。