python3 Scrapy爬虫框架ip代理配置的方法
什么是Scrapy?
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍。所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等)的具有很强通用性的项目模板。对于框架的学习,重点是要学习其框架的特性、各个功能的用法即可。
一、背景
在做爬虫项目的过程中遇到ip代理的问题,网上搜了一些,要么是用阿里云的ip代理,要么是搜一些网上现有的ip资源,然后配置在setting文件中。这两个方法都存在一些问题。
1、阿里云ip代理方法,网上大都是配置阿里云的ip代理的用户名、密码然后加密、解密。我按照上面的方面操作,发现阿里云上面的ip代理的参数里面没有用户名、密码相关的参数配置了。
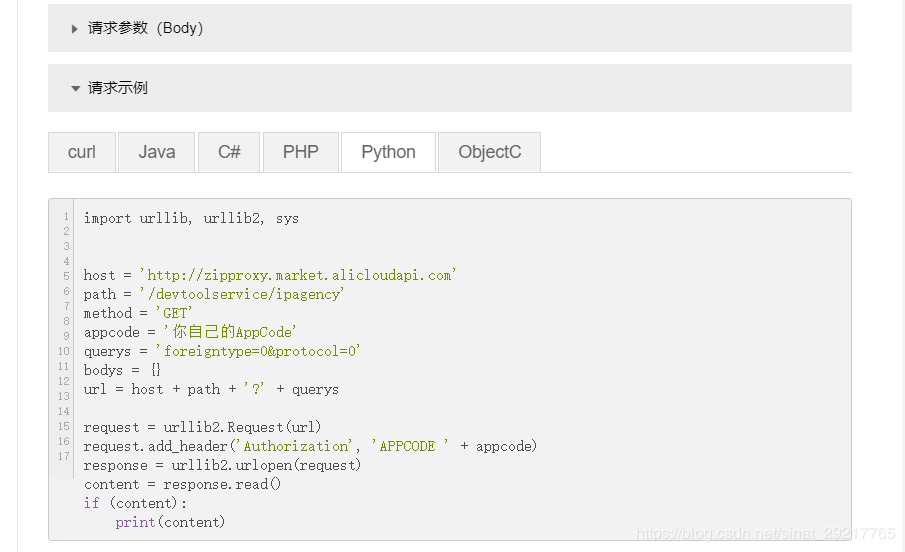
2、至于网上查到的另外一种方法是在setting文件里面添加代理IP资源池,然后再在middlewares.py文件里面添加上一些代码来实现,但代理ip不一定是可用的。
二、改进方法
1、基于背景中提到的网上两种方法的局限性,我在此综合了两种方法。
2、改进方法:
1)利用阿里云的ip代理API生成50个代理IP资源池(用自己的阿里云账号登陆生成的,ip有效性得到保障)
2)直接在middlewares.py中添加如下函数,PROXIES为在阿里云上面生成的ip,此处涉及到个人隐私,故用****代替。
class my_proxy(object):
  def process_request(self, request, spider):
    PROXIES = ['http://****.****.****.****:8080']
    ip = random.choice(PROXIES)
    request.meta['Proxy-Authorization'] = ip
注意:request.meta的方括号里面的关键字需要写对,不然无法正常运行。
总结
以上所述是小编给大家介绍的python3 Scrapy爬虫框架ip代理配置的方法,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!
如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!