python3爬虫怎样构建请求header

yipeiwu_com7年前Python爬虫

写一个爬虫首先就是学会设置请求头header,这样才可以伪装成浏览器。下面小编我就来给大家简单分析一下python3怎样构建一个爬虫的请求头header。

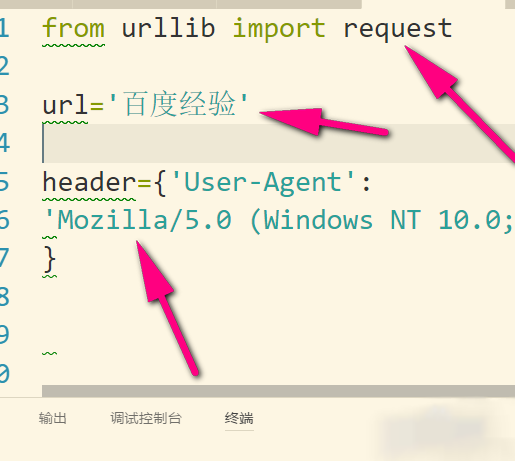
1、python3跟2有了细微差别,所以我们先要引入request,python2没有这个request哦。然后复制网址给url,然后用一个字典来保存header,这个header怎么来的?看第2步。
2、打开任意浏览器某一页面(要联网),按f12,然后点network,之后再按f5,然后就会看到“name”这里,我们点击name里面的任意文件即可。
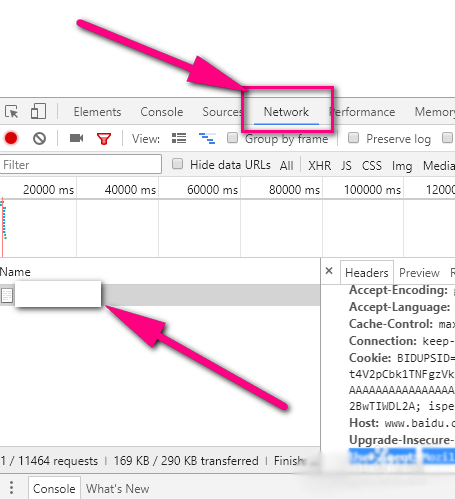
3、之后右边有一个headers,点击headers找到request headers,这个就是浏览器的请求报头了。
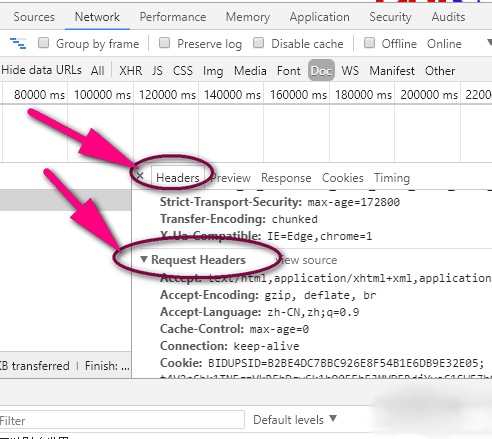
4、然后复制其中的user-agent,其他的cookie还有Accept可以要也可以不要,主要是伪装成浏览器,所以我就用了user-agent

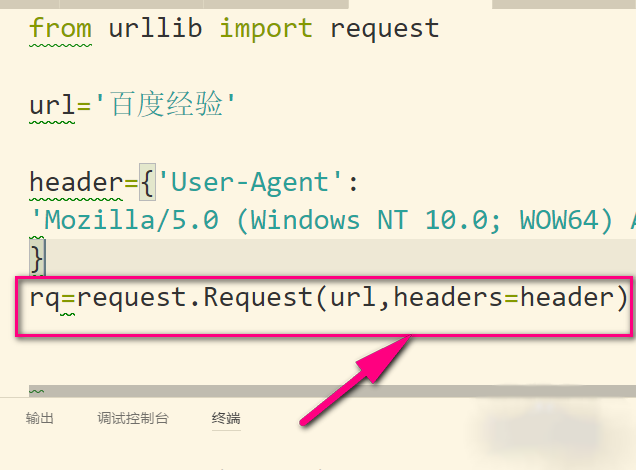
5、接着再用Request方法把url和headers组合在一起就可以构造一个比较简单的请求了。Request有三个参数(url,data,headers),如果有使用data就是post请求了,没有就是get请求。这里我没有data,所以我就指定headers=header,不然header就会被当成data了。
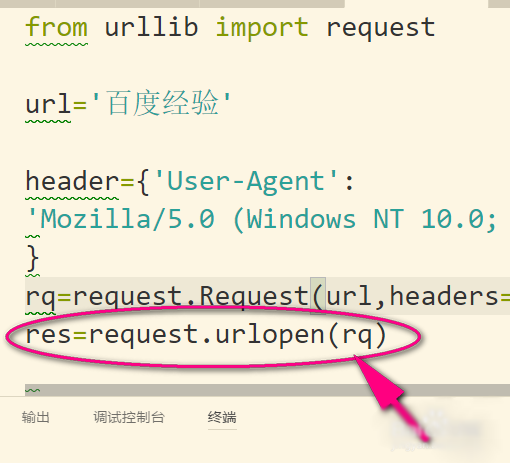
6、请求对象rq就构造好了,然后用urlopen发送这个请求对象就可以了。这就是简单的请求头设置了。
 总结:以上就是关于python3爬虫怎样构建请求头的相关知识点,感谢大家的阅读和对【听图阁-专注于Python设计】的支持。
相关文章

Python爬取当当、京东、亚马逊图书信息代码实例

Python爬取当当、京东、亚马逊图书信息代码实例

注:1.本程序采用MSSQLserver数据库存储,请运行程序前手动修改程序开头处的数据库链接信息 2.需要bs4、requests、pymssql库支持 3.支持多线程 from...

python爬虫爬取笔趣网小说网站过程图解

python爬虫爬取笔趣网小说网站过程图解

首先:文章用到的解析库介绍 BeautifulSoup: Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。 它是一个工具箱,通过解析...

详解Selenium+PhantomJS+python简单实现爬虫的功能

Selenium 一、简介 selenium是一个用于Web应用自动化程序测试的工具,测试直接运行在浏览器中,就像真正的用户在操作一样 selenium2支持通过驱动真实浏览器(Fi...

以视频爬取实例讲解Python爬虫神器Beautiful Soup用法

1.安装BeautifulSoup4 easy_install安装方式,easy_install需要提前安装 easy_install beautifulsoup4 pip安装方...

python爬取cnvd漏洞库信息的实例

python爬取cnvd漏洞库信息的实例

今天一同事需要整理http://ics.cnvd.org.cn/工控漏洞库里面的信息,一看960多个要整理到什么时候才结束。 所以我决定写个爬虫帮他抓取数据。 看了一下各类信息还是很规则...