python批量爬取下载抖音视频
本文实例为大家分享了python批量爬取下载抖音视频的具体代码,供大家参考,具体内容如下
import os
import requests
import re
import sys
import asyncio
import aiohttp

headers = {
  'user-agent': 'Mozilla/5.0 (iPhone; CPU iPhone OS 11_0 like Mac OS X) AppleWebKit/604.1.38 (KHTML, like Gecko) '
         'Version/11.0 Mobile/15A372 Safari/604.1'
}

VIDEO_URLS, PAGE = [], 1


def get_info(url):
  """
  :param url: 用户的链接
  :return:返回name,dytk,user_id 参数
  """
  name = None
  dytk = None
  user_id = None
  try:
    response = requests.get(url, headers=headers)
    user_id = response.url.split('/')[5].split('?')[0]
    name = re.search(r'class="nickname">(.*?)<', response.text)[1]
    dytk = re.search(r"dytk: '(.*?)'", response.text)[1]
  except (TypeError, IndexError):
    sys.stdout.write('Waring:输入的链接错误')
  except requests.exceptions:
    sys.stdout.write('Waring:链接错误')
  finally:
    return name, user_id, dytk


def make_dir(name):
  """
  建立文件夹
  :param name: 用户名称
  :return:
  """
  if not os.path.isdir(name):
    os.mkdir(name)
  else:
    pass


def get_all_video(user_id, max_cursor, dytk):
  """
  获取视频的地址
  :param user_id:
  :param max_cursor:
  :param dytk:
  :return:
  """
  url = "https://www.amemv.com/aweme/v1/aweme/post/?"
  params = {'user_id': user_id,
       'count': 21,
       'max_cursor': max_cursor,
       'dytk': dytk}
  try:
    response = requests.get(url=url, params=params, headers=headers)
    if response.status_code == 200:
      datas = response.json()
      for data in datas['aweme_list']:
        name = data.get('share_info').get('share_desc')
        url = data.get('video').get('play_addr').get('url_list')[0].replace('playwm', 'play')
        VIDEO_URLS.append([name, url])
      if datas['has_more'] == 1 and datas.get('max_cursor') != 0:
        global PAGE
        print(f'收集第{PAGE}页视频')
        PAGE += 1
        return get_all_video(user_id, datas.get('max_cursor'), dytk)
      else:
        print('收集完成')
        return VIDEO_URLS
    else:
      print('状态码:', response.status_code)
      return None
  except Exception as e:
    print('Waring:', e)
    return


async def download_video(index, name, video_name, url):
  """
  下载视频
  :param index:  视频id
  :param name:  用户名称
  :param video_name: 视频名称
  :param url:   下载url
  :return:
  """
  print(f'正在下载第{index}个视频:{video_name}')
  video_path = '{}/{}.mp4'.format(name, video_name)
  if not os.path.isfile(video_path):
    try:
      async with aiohttp.ClientSession() as session:
        async with session.get(url=url, headers=headers, ssl=False) as response:
          with open(video_path, 'wb') as f:
            while True:
              chunk = await response.content.read(1024)
              f.write(chunk)
              if not chunk:
                break
            print(f'下载完成第{index}个视频:{video_name}')
    except Exception as e:
      print('waring:download faild', video_name, e)
      return
  else:
    print('文件已存在')


def main():
  url = 'http://v.douyin.com/dEorkn/'
  name, user_id, dytk = get_info(url)
  if not (name, user_id, dytk):
    return
  make_dir(name)
  get_all_video(user_id, 0, dytk)
  print(f'{name}:总共有{len(VIDEO_URLS)}个视频')
  tasks = []
  for index, item in enumerate(VIDEO_URLS, 1):
    video_name = item[0]
    url = item[1]
    tasks.append(asyncio.ensure_future(download_video(index, name, video_name, url)))
  loop = asyncio.get_event_loop()
  loop.run_until_complete(asyncio.wait(tasks))
  loop.run_until_complete(asyncio.sleep(0))
  loop.close()
  print(f'{name}视频下载完成!')


if __name__ == '__main__':
  main()
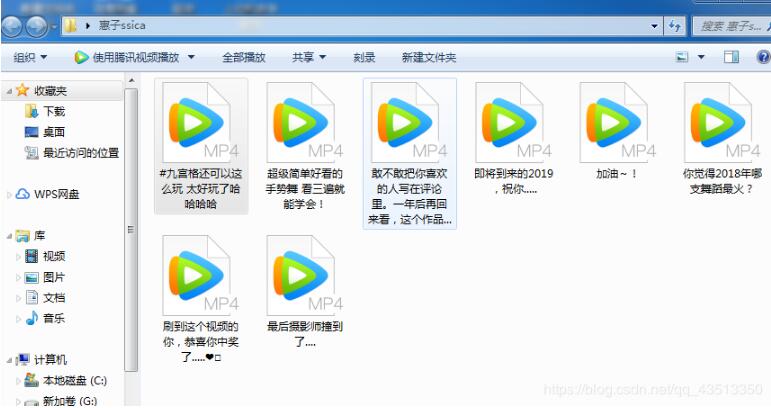
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。