pandas DataFrame 删除重复的行的实现方法
1. 建立一个DataFrame
C=pd.DataFrame({'a':['dog']*3+['fish']*3+['dog'],'b':[10,10,12,12,14,14,10]})
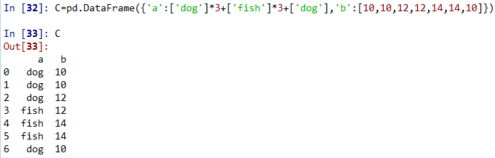
2. 判断是否有重复项
用duplicated( )函数判断
C.duplicated()

3. 有重复项,则可以用drop_duplicates()移除重复项
C.drop_duplicates()
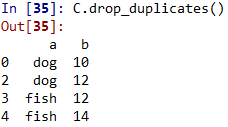
4. Duplicated( )和drop_duplicates( )方法是以默认的方式判断全部的列(上面的例子中是看两个变量a和b是否都是重复出现)。
我们也可以对特定的列进行重复项判断。
 C.duplicated(['a'])   C.drop_duplicates(['a'])

 C.duplicated(['b'])   C.drop_duplicates(['b'])

5. norepeat_df = df.drop_duplicates(subset=['A_ID', 'B_ID'], keep='first')
#上面的命令去掉UNIT_ID和KPI_ID列中重复的行,并保留重复出现的行中第一次出现的行
补充:
- 当keep=False时,就是去掉所有的重复行
- 当keep=‘first'时,就是保留第一次出现的重复行
- 当keep='last'时就是保留最后一次出现的重复行。
(注意,这里的参数是字符串,要加引号!!!)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。
