python使用beautifulsoup4爬取酷狗音乐代码实例
这篇文章主要介绍了python使用beautifulsoup4爬取酷狗音乐代码实例,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下
小编经常在网上听一些音乐但是有一些网站好多音乐都是付费下载的正好我会点爬虫技术,空闲时间写了一份,截止4月底没有问题的,会下载到当前目录,只要按照bs4库就好,
安装方法:pip install beautifulsoup4
完整代码如下:双击就能直接运行
from bs4 import BeautifulSoup
import requests
import re
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.109 Safari/537.36'
}
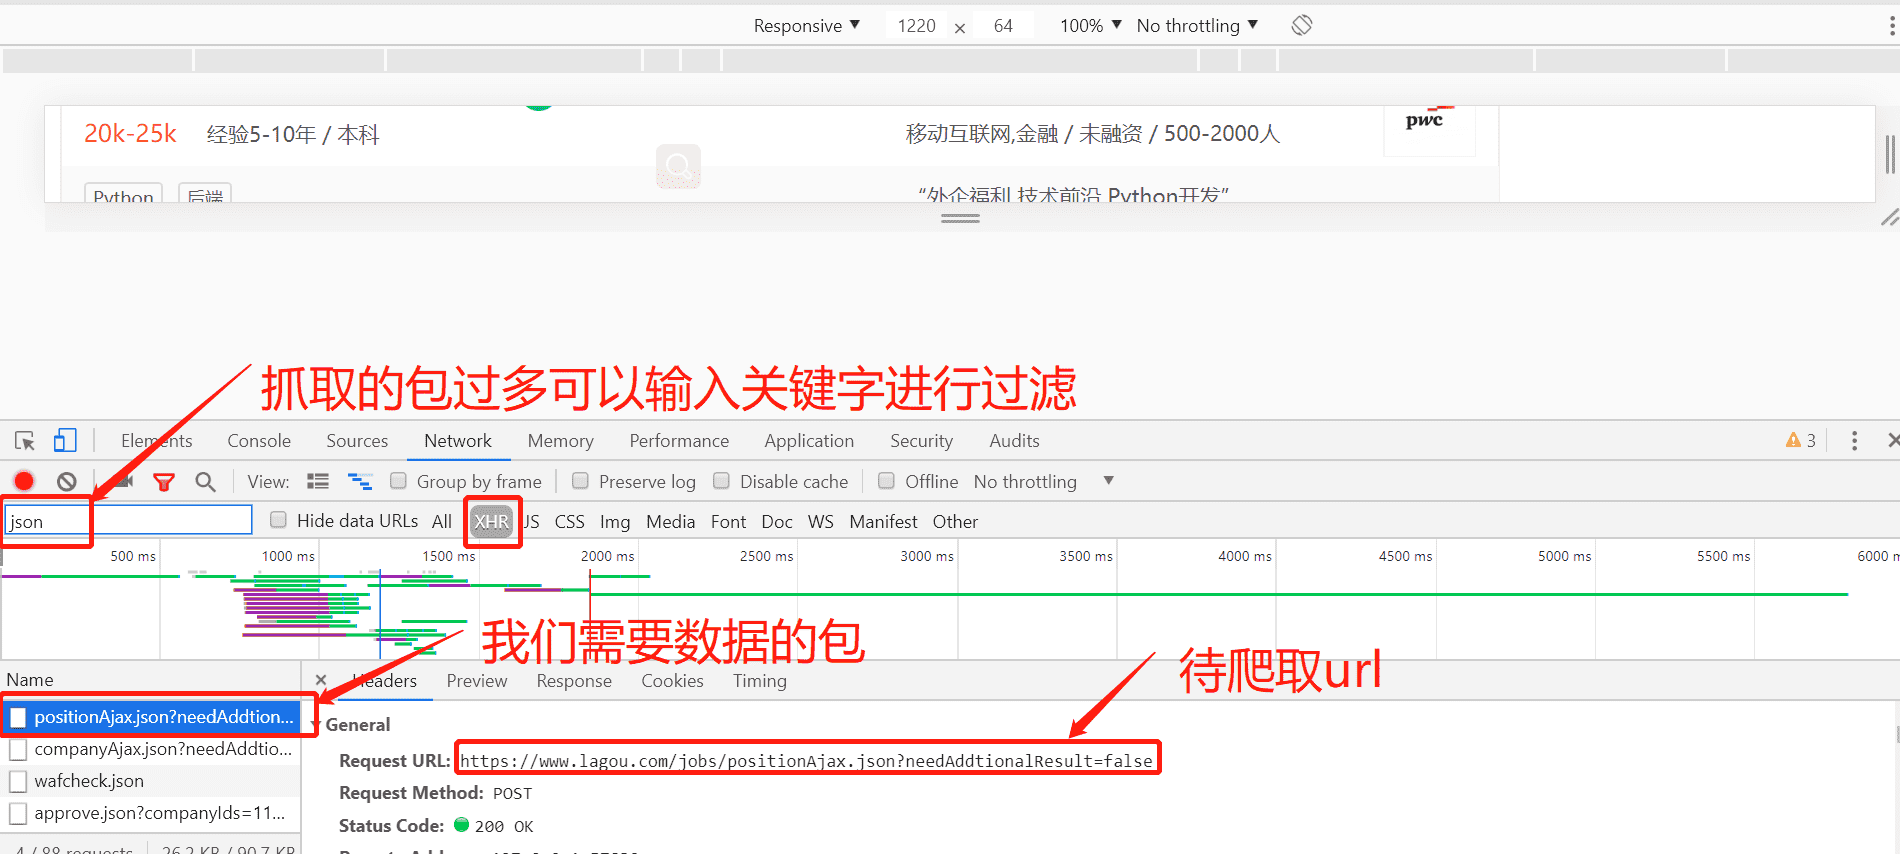
url='https://songsearch.kugou.com/song_search_v2?&page=1&pagesize=30&userid=-1&clientver=&platform=WebFilter&tag=em&filter=2&iscorrection=1&privilege_filter=0&_=1555124510574'
#想要爬取别的网页直接修改这个json数据地址就行
r=requests.get(url,headers=headers)
soup=BeautifulSoup(r.text,'lxml')
title_list=soup.select('.pc_temp_songlist ul li')
hash=re.findall(r',"FileHash":"(.*?)"',r.text)
hash1=re.findall(r',"FileName":"(.*?)"',r.text)
#直接用正则匹配隐藏的数据
print(hash)
print(hash1)
q=0
for url in hash:
url_a=f'https://wwwapi.kugou.com/yy/index.php?r=play/getdata&callback=jQuery1910212680783679835_1555073815772&hash={url}&album_id=18784389'
#这个URL不用修改的
c=requests.get(url_a,headers=headers)
a=c.text[40:-3]
b=re.findall('"play_url":"(.*)","authors":',a)[0]
b1=re.sub(r"\\",'',b)
f = requests.get(b1)
with open(hash1[q]+'.mp3','wb')as d:
d.write(f.content)
print(hash1[q])
q+=1
爬取酷狗的唯一难点就是hash值的获取找了一个多小时才找到,比网易云好点就是自己不用写一个哈希值,酷狗是自己就存在的能找到,网易云是需要函数生成的。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。