python编写朴素贝叶斯用于文本分类
朴素贝叶斯估计
朴素贝叶斯是基于贝叶斯定理与特征条件独立分布假设的分类方法。首先根据特征条件独立的假设学习输入/输出的联合概率分布,然后基于此模型,对给定的输入x,利用贝叶斯定理求出后验概率最大的输出y。
具体的,根据训练数据集,学习先验概率的极大似然估计分布
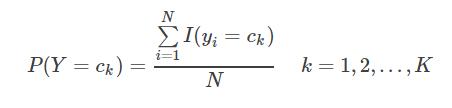
以及条件概率为
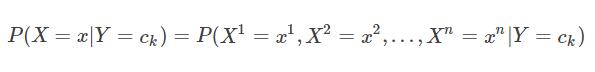
Xl表示第l个特征,由于特征条件独立的假设,可得
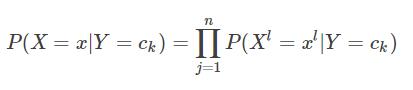
条件概率的极大似然估计为
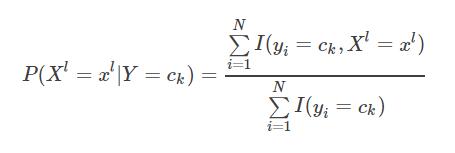
根据贝叶斯定理
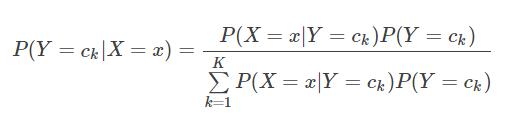
则由上式可以得到条件概率P(Y=ck|X=x)。
贝叶斯估计
用极大似然估计可能会出现所估计的概率为0的情况。后影响到后验概率结果的计算,使分类产生偏差。采用如下方法解决。
条件概率的贝叶斯改为
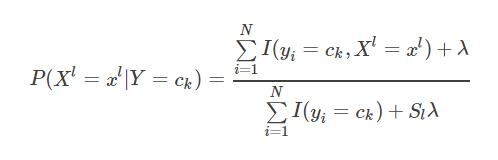
其中Sl表示第l个特征可能取值的个数。
同样,先验概率的贝叶斯估计改为
$$
P(Y=c_k) = \frac{\sum\limits_{i=1}^NI(y_i=c_k)+\lambda}{N+K\lambda}
$K$
表示Y的所有可能取值的个数,即类型的个数。
具体意义是,给每种可能初始化出现次数为1,保证每种可能都出现过一次,来解决估计为0的情况。
文本分类
朴素贝叶斯分类器可以给出一个最有结果的猜测值,并给出估计概率。通常用于文本分类。
分类核心思想为选择概率最大的类别。贝叶斯公式如下:
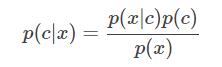
词条:将每个词出现的次数作为特征。
假设每个特征相互独立,即每个词相互独立,不相关。则
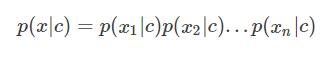
完整代码如下;
import numpy as np
import re
import feedparser
import operator
def loadDataSet():
 postingList=[['my', 'dog', 'has', 'flea', 'problems', 'help', 'please'],
     ['maybe', 'not', 'take', 'him', 'to', 'dog', 'park', 'stupid'],
     ['my', 'dalmation', 'is', 'so', 'cute', 'I', 'love', 'him'],
     ['stop', 'posting', 'stupid', 'worthless', 'garbage'],
     ['mr', 'licks', 'ate', 'my', 'steak', 'how', 'to', 'stop', 'him'],
     ['quit', 'buying', 'worthless', 'dog', 'food', 'stupid']]
 classVec = [0,1,0,1,0,1] #1 is abusive, 0 not
 return postingList,classVec

def createVocabList(data): #创建词向量
 returnList = set([])
 for subdata in data:
  returnList = returnList | set(subdata)
 return list(returnList)


def setofWords2Vec(vocabList,data):  #将文本转化为词条

 returnList = [0]*len(vocabList)
 for vocab in data:
  if vocab in vocabList:
   returnList[vocabList.index(vocab)] += 1
 return returnList


def trainNB0(trainMatrix,trainCategory):  #训练,得到分类概率
 pAbusive = sum(trainCategory)/len(trainCategory)
 p1num = np.ones(len(trainMatrix[0]))
 p0num = np.ones(len(trainMatrix[0]))
 p1Denom = 2
 p0Denom = 2
 for i in range(len(trainCategory)):
  if trainCategory[i] == 1:
   p1num = p1num + trainMatrix[i]
   p1Denom = p1Denom + sum(trainMatrix[i])
  else:
   p0num = p0num + trainMatrix[i]
   p0Denom = p0Denom + sum(trainMatrix[i])
 p1Vect = np.log(p1num/p1Denom)
 p0Vect = np.log(p0num/p0Denom)
 return p0Vect,p1Vect,pAbusive


def classifyNB(vec2Classify,p0Vec,p1Vec,pClass1): #分类
 p0 = sum(vec2Classify*p0Vec)+np.log(1-pClass1)
 p1 = sum(vec2Classify*p1Vec)+np.log(pClass1)
 if p1 > p0:
  return 1
 else:
  return 0
def textParse(bigString):   #文本解析
 splitdata = re.split(r'\W+',bigString)
 splitdata = [token.lower() for token in splitdata if len(token) > 2]
 return splitdata
def spamTest():
 docList = []
 classList = []
 for i in range(1,26):
  with open('spam/%d.txt'%i) as f:
   doc = f.read()
  docList.append(doc)
  classList.append(1)
  with open('ham/%d.txt'%i) as f:
   doc = f.read()
  docList.append(doc)
  classList.append(0)
 vocalList = createVocabList(docList)
 trainList = list(range(50))
 testList = []
 for i in range(13):
  num = int(np.random.uniform(0,len(docList))-10)
  testList.append(trainList[num])
  del(trainList[num])
 docMatrix = []
 docClass = []
 for i in trainList:
  subVec = setofWords2Vec(vocalList,docList[i])
  docMatrix.append(subVec)
  docClass.append(classList[i])
 p0v,p1v,pAb = trainNB0(docMatrix,docClass)
 errorCount = 0
 for i in testList:
  subVec = setofWords2Vec(vocalList,docList[i])
  if classList[i] != classifyNB(subVec,p0v,p1v,pAb):
   errorCount += 1
 return errorCount/len(testList)

def calcMostFreq(vocabList,fullText):
 count = {}
 for vocab in vocabList:
  count[vocab] = fullText.count(vocab)
 sortedFreq = sorted(count.items(),key=operator.itemgetter(1),reverse=True)
 return sortedFreq[:30]

def localWords(feed1,feed0):
 docList = []
 classList = []
 fullText = []
 numList = min(len(feed1['entries']),len(feed0['entries']))
 for i in range(numList):
  doc1 = feed1['entries'][i]['summary']
  docList.append(doc1)
  classList.append(1)
  fullText.extend(doc1)
  doc0 = feed0['entries'][i]['summary']
  docList.append(doc0)
  classList.append(0)
  fullText.extend(doc0)
 vocabList = createVocabList(docList)
 top30Words = calcMostFreq(vocabList,fullText)
 for word in top30Words:
  if word[0] in vocabList:
   vocabList.remove(word[0])
 trainingSet = list(range(2*numList))
 testSet = []
 for i in range(20):
  randnum = int(np.random.uniform(0,len(trainingSet)-5))
  testSet.append(trainingSet[randnum])
  del(trainingSet[randnum])
 trainMat = []
 trainClass = []
 for i in trainingSet:
  trainClass.append(classList[i])
  trainMat.append(setofWords2Vec(vocabList,docList[i]))
 p0V,p1V,pSpam = trainNB0(trainMat,trainClass)
 errCount = 0
 for i in testSet:
  testData = setofWords2Vec(vocabList,docList[i])
  if classList[i] != classifyNB(testData,p0V,p1V,pSpam):
   errCount += 1
 return errCount/len(testData)
if __name__=="__main__":
 ny = feedparser.parse('http://newyork.craigslist.org/stp/index.rss')
 sf = feedparser.parse('http://sfbay.craigslist.org/stp/index.rss')
 print(localWords(ny,sf))
编程技巧:
1.两个集合的并集
vocab = vocab | set(document)
2.创建元素全为零的向量
vec = [0]*10
代码及数据集下载:贝叶斯
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。


