Python3 解决读取中文文件txt编码的问题
问题描述
尝试用Python写一个Wordcloud的时候,出现了编码问题。
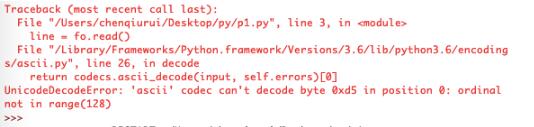
照着网上某些博客的说法添添改改后,结果是变成了“UnicodeDecodeError: ‘utf-8' codec can't decode byte…”这个错误。
捣鼓了一天啊,TXT(此处为本人现下内心表情)。最后,干脆写个最简单的文件读取,竟然还是报错。于是就考虑是不是txt的编码问题,因为读取的txt文件是在Mac上面新建的纯文本文件,一时没找到在哪里查看编码,最后拷贝到Windows系统上,查看了txt文件的编码,竟然是ASCII,不是我最爱的utf-8,Mac你辜负了我对你的一番信任啊!ε(┬┬﹏┬┬)3
解决方法
将txt文件的编码格式改为utf-8即可
此外,在打开文件的时候,要加上第三个参数encoding=‘utf8'(没有横杠)。
with open('./test3.txt','r',encoding='utf8') as fin:
  for line in fin.readlines():
    line = line.strip('\n')
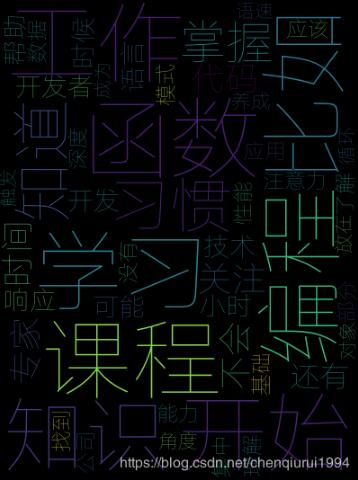
下面附上第一次成功显示的词云的源码(参考网上他人的,注释很详细)
import jieba
import jieba.analyse
from matplotlib import pyplot as plt
from scipy.misc import imread
from wordcloud import WordCloud,STOPWORDS,ImageColorGenerator

# 1.读取数据
with open("./test.txt","r",encoding="utf8") as f:
  text = f.read()

# 2.基于 TextRank 算法的关键词抽取,top50
keywords = jieba.analyse.textrank(text, topK=50, withWeight=False, allowPOS=('ns', 'n', 'vn', 'v'))
file = ",".join(keywords)

# 指定中文字体,不然中文显示框框
font = r'./HYQiHei-25J.ttf'
print(file)
# 指定背景图,随意
image = imread('cake.jpg')
wc = WordCloud(
  font_path=font,
  background_color='white',#背景色
  mask=image,#背景图
  stopwords=STOPWORDS,#设置停用词
  max_words=100,#设置最大文字数
  max_font_size=100,#设置最大字体
  width=800,
  height=1000,

)

#生成词云
image_colors = ImageColorGenerator(image)
wc.generate(file)

# 使用matplotlib,显示词云图
plt.imshow(wc) #显示词云图
plt.axis('off') #关闭坐标轴
plt.show()
# 保存图片
wc.to_file('news.png')
以上这篇Python3 解决读取中文文件txt编码的问题就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。