下载给定网页上图片的方法

yipeiwu_com7年前Python基础
复制代码 代码如下:

# -*- coding: utf-8 -*-
import re
import urllib
def getHtml(url):
#找出给出网页的源码
page = urllib.urlopen(url)
html = page.read()
return html

def getImg(html):
#正则
reg = r'src="(.*?\.jpg)"'
#编译正则
imgre = re.compile(reg)
#找出图片地址
imglist = re.findall(imgre,html)
#循环遍历
x = 0
for i in imglist:
urllib.urlretrieve(i,'%s.jpg' % x)
x+=1
html = getHtml(r'http://www.renren.com/')
getImg(html)

相关文章

Django项目中实现使用qq第三方登录功能

Django项目中实现使用qq第三方登录功能

使用qq登录的前提是已经在qq互联官网创建网站应用并获取到QQ互联中网站应用的APP ID和APP KEY 1,建路由 # qq登录 path('loginQq/',qq.log...

谈谈python中GUI的选择

尽管内容可能有些老,但是没有关系,对于想深入Python开发的工作者,在选择GUI开发包,乃至可视化IDE方面都还有相当的借鉴意义。 Python最大的特点就在于她的快速开发功能。作为一...

python遍历文件夹下所有excel文件

大数据处理经常要用到一堆表格,然后需要把数据导入一个list中进行各种算法分析,简单讲一下自己的做法: 1.如何读取excel文件 网上的版本很多,在xlrd模块基础上,找到一些源码...

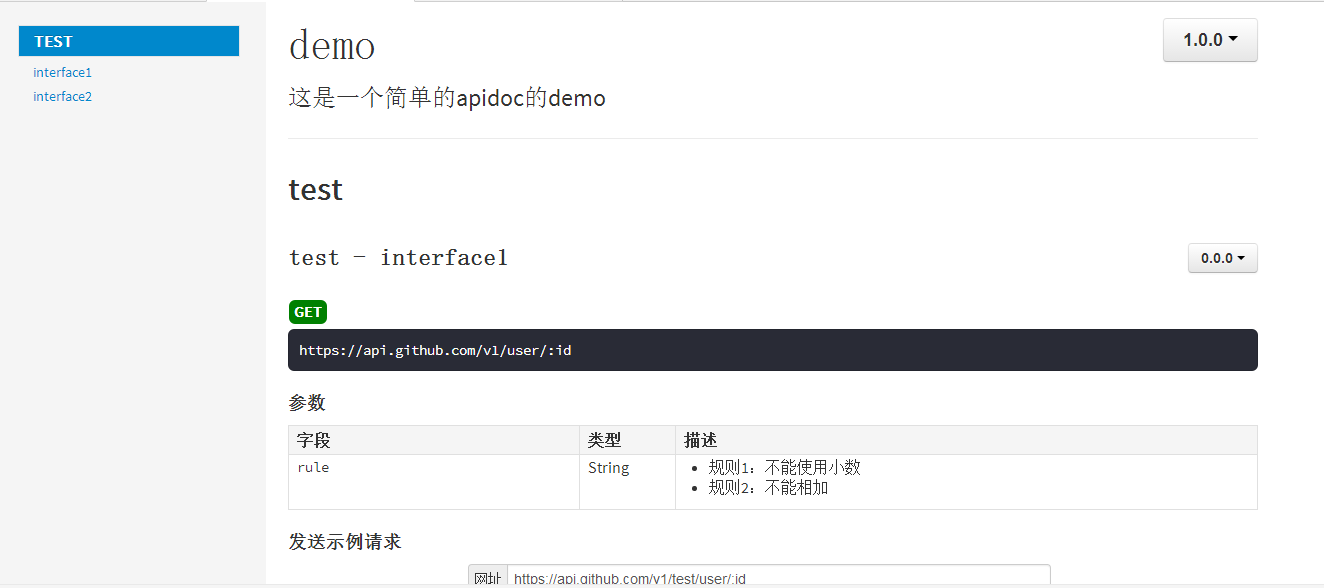
使用apidocJs快速生成在线文档的实例讲解

使用apidocJs快速生成在线文档的实例讲解

apidoc是一个轻量级的在线REST接口文档生成系统,支持多种主流语言,包括Java、C、C#、PHP和Javascript等。使用者仅需要按照要求书写相关注释,就可以生成可读性好、界...

python中使用urllib2伪造HTTP报头的2个方法

在采集网页信息的时候,经常需要伪造报头来实现采集脚本的有效执行 下面,我们将使用urllib2的header部分伪造报头来实现采集信息 方法1、 #!/usr/bin/python...