python抓取网页中的图片示例

yipeiwu_com7年前Python爬虫

复制代码 代码如下:

#coding:utf8
import re
import urllib
def getHTML(url):
    page = urllib.urlopen(url)
    html = page.read()
    return html

def getImg(html,imgType):
    reg = r'src="(.*?\.+'+imgType+'!slider)" '
    imgre = re.compile(reg)
    imgList = re.findall(imgre, html)
    x=0
    for imgurl in imgList:
        print imgurl
        urllib.urlretrieve(imgurl, '%s.%s' % (x, imgType))
        x =x+1


html= getHTML("//www.jb51.net")

getImg(html,'jpg')
相关文章

python爬取指定微信公众号文章

本文实例为大家分享了python爬取微信公众号文章的具体代码,供大家参考,具体内容如下 该方法是依赖于urllib2库来完成的,首先你需要安装好你的python环境,然后安装urllib...

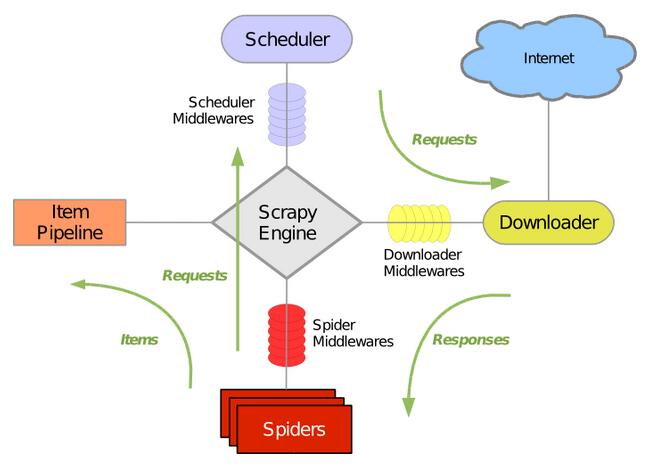
Python抓取框架 Scrapy的架构

Python抓取框架 Scrapy的架构

最近在学Python,同时也在学如何使用python抓取数据,于是就被我发现了这个非常受欢迎的Python抓取框架Scrapy,下面一起学习下Scrapy的架构,便于更好的使用这个工具。...

Python开发实例分享bt种子爬虫程序和种子解析

看到网上也有开源的代码,这不,我拿来进行了二次重写,呵呵,上代码:  #encoding: utf-8     &n...

Python实现并行抓取整站40万条房价数据(可更换抓取城市)

Python实现并行抓取整站40万条房价数据(可更换抓取城市)

写在前面 这次的爬虫是关于房价信息的抓取,目的在于练习10万以上的数据处理及整站式抓取。 数据量的提升最直观的感觉便是对函数逻辑要求的提高,针对Python的特性,谨慎的选择数据结构。以...

Python使用Selenium模块实现模拟浏览器抓取淘宝商品美食信息功能示例

本文实例讲述了Python使用Selenium模块实现模拟浏览器抓取淘宝商品美食信息功能。分享给大家供大家参考,具体如下: import re from selenium impor...