详解Python静态网页爬取获取高清壁纸
前言
在设计爬虫项目的时候,首先要在脑内明确人工浏览页面获得图片时的步骤
一般地,我们去网上批量打开壁纸的时候一般操作如下:
1、打开壁纸网页
2、单击壁纸图(打开指定壁纸的页面)
3、选择分辨率(我们要下载高清的图)
4、保存图片
实际操作时,我们实现了如下几步网页地址的访问:打开了壁纸的网页→单击壁纸图打开指定页面→选择分辨率,点击后打开最终保存目标图片网页→保存图片
在爬虫的过程中我们就尝试通过模拟浏览器打开网页的操作,一步步获得、访问网页、最后获得目标图片的下载地址,对图片进行下载保存到指定路径中
*这些中间过程中网页的一些具体筛选条件的构造,需要打开指定页面的源代码去观察和寻找包含有目的链接的标签
具体实现项目与注释
这里我只想获得一些指定的图片,所以我先在网页上搜索“长门有希”,打开了一个搜索结果页面,发现在这个页面上就已经包含了同类型的其他壁纸链接,于是我一开始就把最初访问的目的地址设置为这个搜索结果页面
目标结果页面截图:
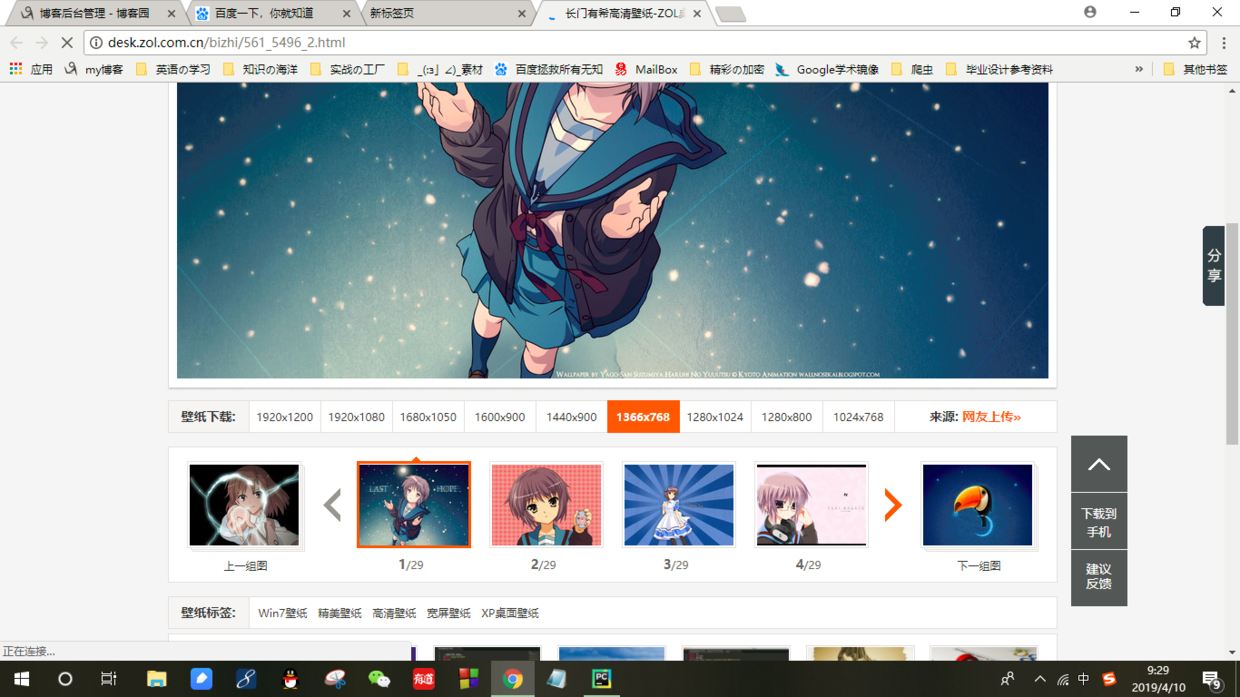
图中下标为"1/29"."2/29"为其他同类型目标壁纸,通过点击这些图片我们可以打开新的目标下载图片页面
这里我们查看一下网页源代码
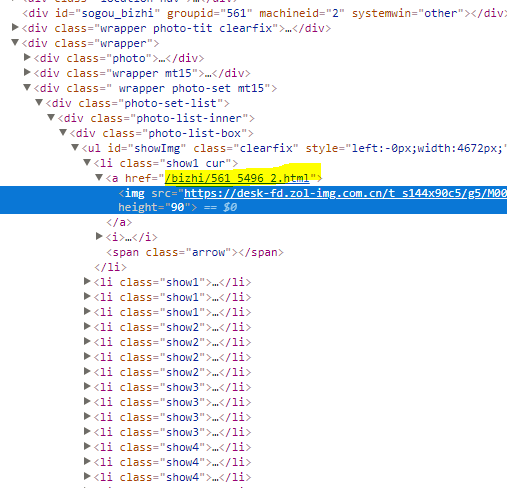
图中黄色底的地方就是打开这些同类壁纸的目的地址(访问的时候需要加上前缀"http://desk.zol.com.cn/")
现在我们可以尝试实现构建爬虫:
打开指定页面→筛选获得所有长门有希壁纸的目标下载页面链接
代码如下:
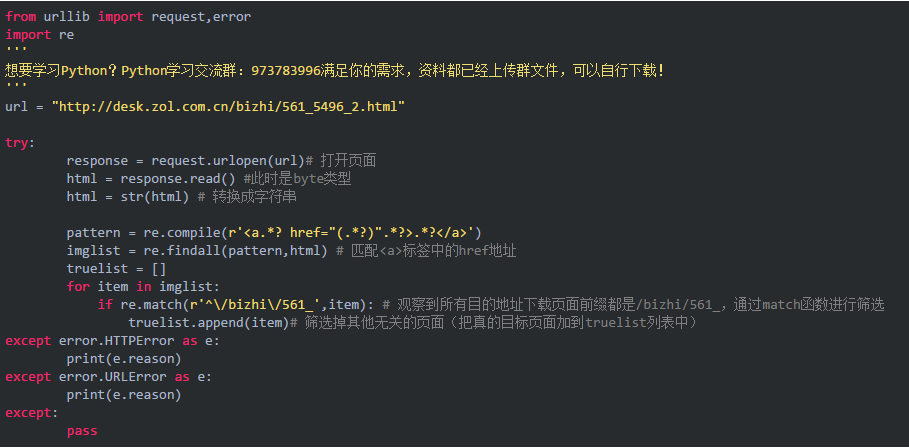
获得地址以后我们可以通过获取地址→打开指定页面→选择分辨率→获得目的下载地址→保存到本地指定路径中
在测试的时候我输出了一下上一步truelist中保存的内容
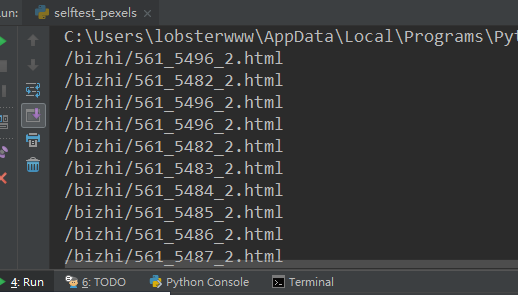
可以看到保存的只是一个后缀,在访问的时候我们需要加上一个指定的前缀
实现代码如下(注释见代码):
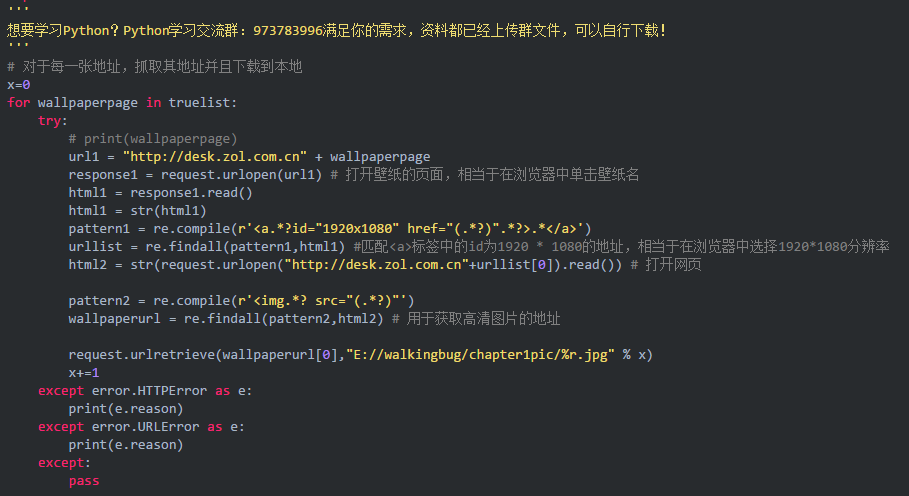
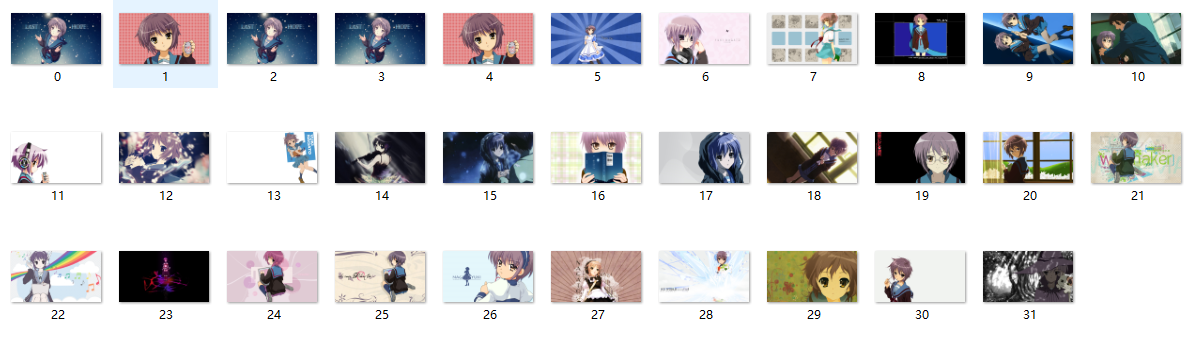
最后可以在自己的目标文件夹中看到爬下来的图片集~
以上所述是小编给大家介绍的Python爬取高清壁纸详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!