kNN算法python实现和简单数字识别的方法
本文实例讲述了kNN算法python实现和简单数字识别的方法。分享给大家供大家参考。具体如下:
kNN算法算法优缺点:
优点:精度高、对异常值不敏感、无输入数据假定
缺点:时间复杂度和空间复杂度都很高
适用数据范围:数值型和标称型
算法的思路:
KNN算法(全称K最近邻算法),算法的思想很简单,简单的说就是物以类聚,也就是说我们从一堆已知的训练集中找出k个与目标最靠近的,然后看他们中最多的分类是哪个,就以这个为依据分类。
函数解析:
库函数:
tile()
如tile(A,n)就是将A重复n次
np.tile(a, 2)
array([0, 1, 2, 0, 1, 2])
np.tile(a, (2, 2))
array([[0, 1, 2, 0, 1, 2],[0, 1, 2, 0, 1, 2]])
np.tile(a, (2, 1, 2))
array([[[0, 1, 2, 0, 1, 2]],[[0, 1, 2, 0, 1, 2]]])
b = np.array([[1, 2], [3, 4]])
np.tile(b, 2)
array([[1, 2, 1, 2],[3, 4, 3, 4]])
np.tile(b, (2, 1))
array([[1, 2],[3, 4],[1, 2],[3, 4]])`
自己实现的函数
createDataSet()生成测试数组
kNNclassify(inputX, dataSet, labels, k)分类函数
inputX 输入的参数
dataSet 训练集
labels 训练集的标号
k 最近邻的数目
#coding=utf-8
from numpy import *
import operator
def createDataSet():
group = array([[1.0, 0.9], [1.0, 1.0], [0.1, 0.2], [0.0, 0.1]])
labels = ['A','A','B','B']
return group,labels
#inputX表示输入向量(也就是我们要判断它属于哪一类的)
#dataSet表示训练样本
#label表示训练样本的标签
#k是最近邻的参数,选最近k个
def kNNclassify(inputX, dataSet, labels, k):
dataSetSize = dataSet.shape[0]#计算有几个训练数据
#开始计算欧几里得距离
diffMat = tile(inputX, (dataSetSize,1)) - dataSet
sqDiffMat = diffMat ** 2
sqDistances = sqDiffMat.sum(axis=1)#矩阵每一行向量相加
distances = sqDistances ** 0.5
#欧几里得距离计算完毕
sortedDistance = distances.argsort()
classCount = {}
for i in xrange(k):
voteLabel = labels[sortedDistance[i]]
classCount[voteLabel] = classCount.get(voteLabel,0) + 1
res = max(classCount)
return res
def main():
group,labels = createDataSet()
t = kNNclassify([0,0],group,labels,3)
print t
if __name__=='__main__':
main()
kNN应用实例
手写识别系统的实现
数据集:
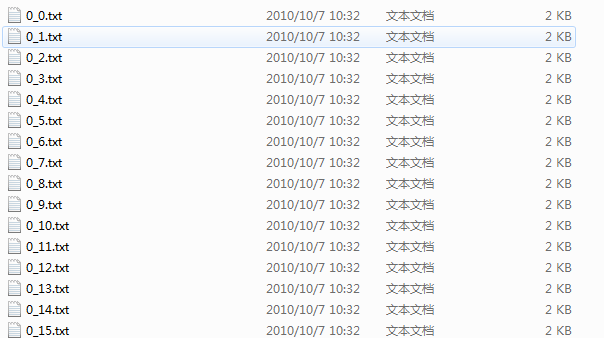
两个数据集:training和test。分类的标号在文件名中。像素32*32的。数据大概这个样子:
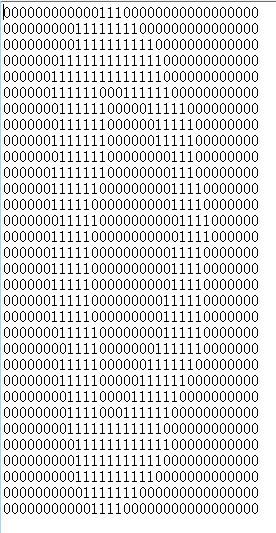
方法:
kNN的使用,不过这个距离算起来比较复杂(1024个特征),主要是要处理如何读取数据这个问题的,比较方面直接调用就可以了。
速度:
速度还是比较慢的,这里数据集是:training 2000+,test 900+(i5的CPU)
k=3的时候要32s+
#coding=utf-8
from numpy import *
import operator
import os
import time
def createDataSet():
group = array([[1.0, 0.9], [1.0, 1.0], [0.1, 0.2], [0.0, 0.1]])
labels = ['A','A','B','B']
return group,labels
#inputX表示输入向量(也就是我们要判断它属于哪一类的)
#dataSet表示训练样本
#label表示训练样本的标签
#k是最近邻的参数,选最近k个
def kNNclassify(inputX, dataSet, labels, k):
dataSetSize = dataSet.shape[0]#计算有几个训练数据
#开始计算欧几里得距离
diffMat = tile(inputX, (dataSetSize,1)) - dataSet
#diffMat = inputX.repeat(dataSetSize, aixs=1) - dataSet
sqDiffMat = diffMat ** 2
sqDistances = sqDiffMat.sum(axis=1)#矩阵每一行向量相加
distances = sqDistances ** 0.5
#欧几里得距离计算完毕
sortedDistance = distances.argsort()
classCount = {}
for i in xrange(k):
voteLabel = labels[sortedDistance[i]]
classCount[voteLabel] = classCount.get(voteLabel,0) + 1
res = max(classCount)
return res
def img2vec(filename):
returnVec = zeros((1,1024))
fr = open(filename)
for i in range(32):
lineStr = fr.readline()
for j in range(32):
returnVec[0,32*i+j] = int(lineStr[j])
return returnVec
def handwritingClassTest(trainingFloder,testFloder,K):
hwLabels = []
trainingFileList = os.listdir(trainingFloder)
m = len(trainingFileList)
trainingMat = zeros((m,1024))
for i in range(m):
fileName = trainingFileList[i]
fileStr = fileName.split('.')[0]
classNumStr = int(fileStr.split('_')[0])
hwLabels.append(classNumStr)
trainingMat[i,:] = img2vec(trainingFloder+'/'+fileName)
testFileList = os.listdir(testFloder)
errorCount = 0.0
mTest = len(testFileList)
for i in range(mTest):
fileName = testFileList[i]
fileStr = fileName.split('.')[0]
classNumStr = int(fileStr.split('_')[0])
vectorUnderTest = img2vec(testFloder+'/'+fileName)
classifierResult = kNNclassify(vectorUnderTest, trainingMat, hwLabels, K)
#print classifierResult,' ',classNumStr
if classifierResult != classNumStr:
errorCount +=1
print 'tatal error ',errorCount
print 'error rate',errorCount/mTest
def main():
t1 = time.clock()
handwritingClassTest('trainingDigits','testDigits',3)
t2 = time.clock()
print 'execute ',t2-t1
if __name__=='__main__':
main()
希望本文所述对大家的Python程序设计有所帮助。