在Python中使用HTMLParser解析HTML的教程
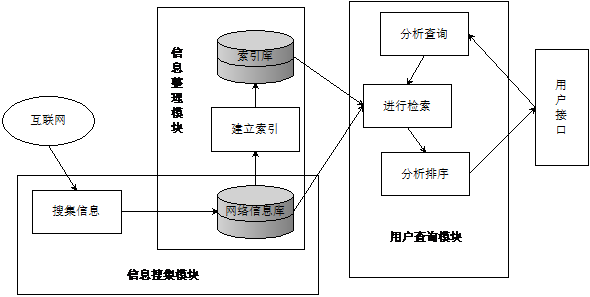
如果我们要编写一个搜索引擎,第一步是用爬虫把目标网站的页面抓下来,第二步就是解析该HTML页面,看看里面的内容到底是新闻、图片还是视频。
假设第一步已经完成了,第二步应该如何解析HTML呢?
HTML本质上是XML的子集,但是HTML的语法没有XML那么严格,所以不能用标准的DOM或SAX来解析HTML。
好在Python提供了HTMLParser来非常方便地解析HTML,只需简单几行代码:
from HTMLParser import HTMLParser
from htmlentitydefs import name2codepoint

class MyHTMLParser(HTMLParser):

  def handle_starttag(self, tag, attrs):
    print('<%s>' % tag)

  def handle_endtag(self, tag):
    print('</%s>' % tag)

  def handle_startendtag(self, tag, attrs):
    print('<%s/>' % tag)

  def handle_data(self, data):
    print('data')

  def handle_comment(self, data):
    print('<!-- -->')

  def handle_entityref(self, name):
    print('&%s;' % name)

  def handle_charref(self, name):
    print('&#%s;' % name)

parser = MyHTMLParser()
parser.feed('<html><head></head><body><p>Some <a href=\"#\">html</a> tutorial...<br>END</p></body></html>')
feed()方法可以多次调用,也就是不一定一次把整个HTML字符串都塞进去,可以一部分一部分塞进去。
特殊字符有两种,一种是英文表示的 ,一种是数字表示的Ӓ,这两种字符都可以通过Parser解析出来。
小结
找一个网页,例如https://www.python.org/events/python-events/,用浏览器查看源码并复制,然后尝试解析一下HTML,输出Python官网发布的会议时间、名称和地点。