python基于BeautifulSoup实现抓取网页指定内容的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了python基于BeautifulSoup实现抓取网页指定内容的方法。分享给大家供大家参考。具体实现方法如下:

# _*_ coding:utf-8 _*_
#xiaohei.python.seo.call.me:)
#win+python2.7.x
import urllib2
from bs4 import BeautifulSoup
def jd(url):
  page = urllib2.urlopen(url)
  html_doc = page.read()
  soup = BeautifulSoup(html_doc.decode('gb2312','ignore'))
  for i in soup.find_all('div', id="sortlist"):
    one = i.find_all('a')
    two = i.find_all('li')
    print ("%s %s" % (one,two))
jd("http://channel.jd.com/computer.html")

希望本文所述对大家的Python程序设计有所帮助。
相关文章

Python爬虫将爬取的图片写入world文档的方法

作为初学爬虫的我,无论是爬取文字还是图片,都可以游刃有余的做到,但是爬虫所爬取的内容往往不是单独的图片或者文字,于是我就想是否可以将图文保存至world文档里,一开始使用了如下方法保存图...

Python3实现的爬虫爬取数据并存入mysql数据库操作示例

Python3实现的爬虫爬取数据并存入mysql数据库操作示例

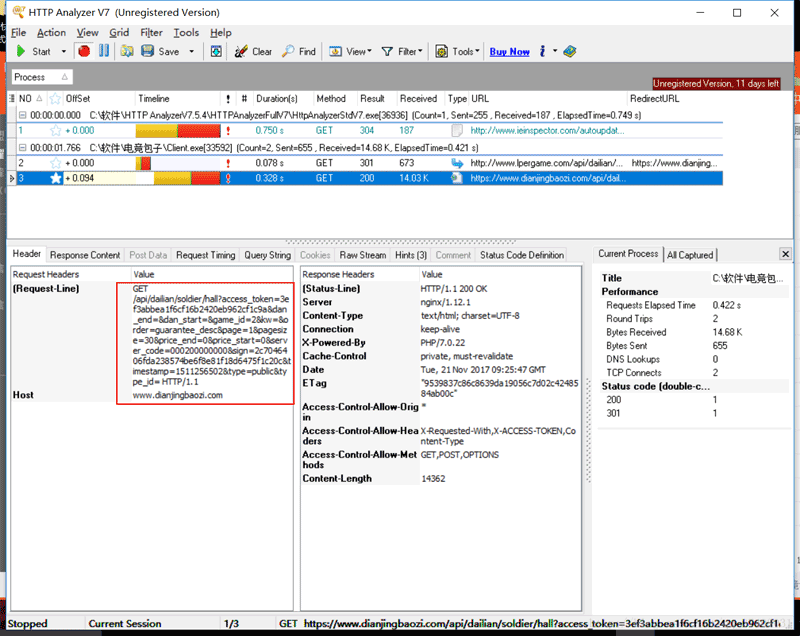
本文实例讲述了Python3实现的爬虫爬取数据并存入mysql数据库操作。分享给大家供大家参考,具体如下: 爬一个电脑客户端的订单。罗总推荐,抓包工具用的是HttpAnalyzerStd...

python爬虫之自动登录与验证码识别

在用爬虫爬取网站数据时,有些站点的一些关键数据的获取需要使用账号登录,这里可以使用requests发送登录请求,并用Session对象来自动处理相关Cookie。 另外在登录时,有些网站...

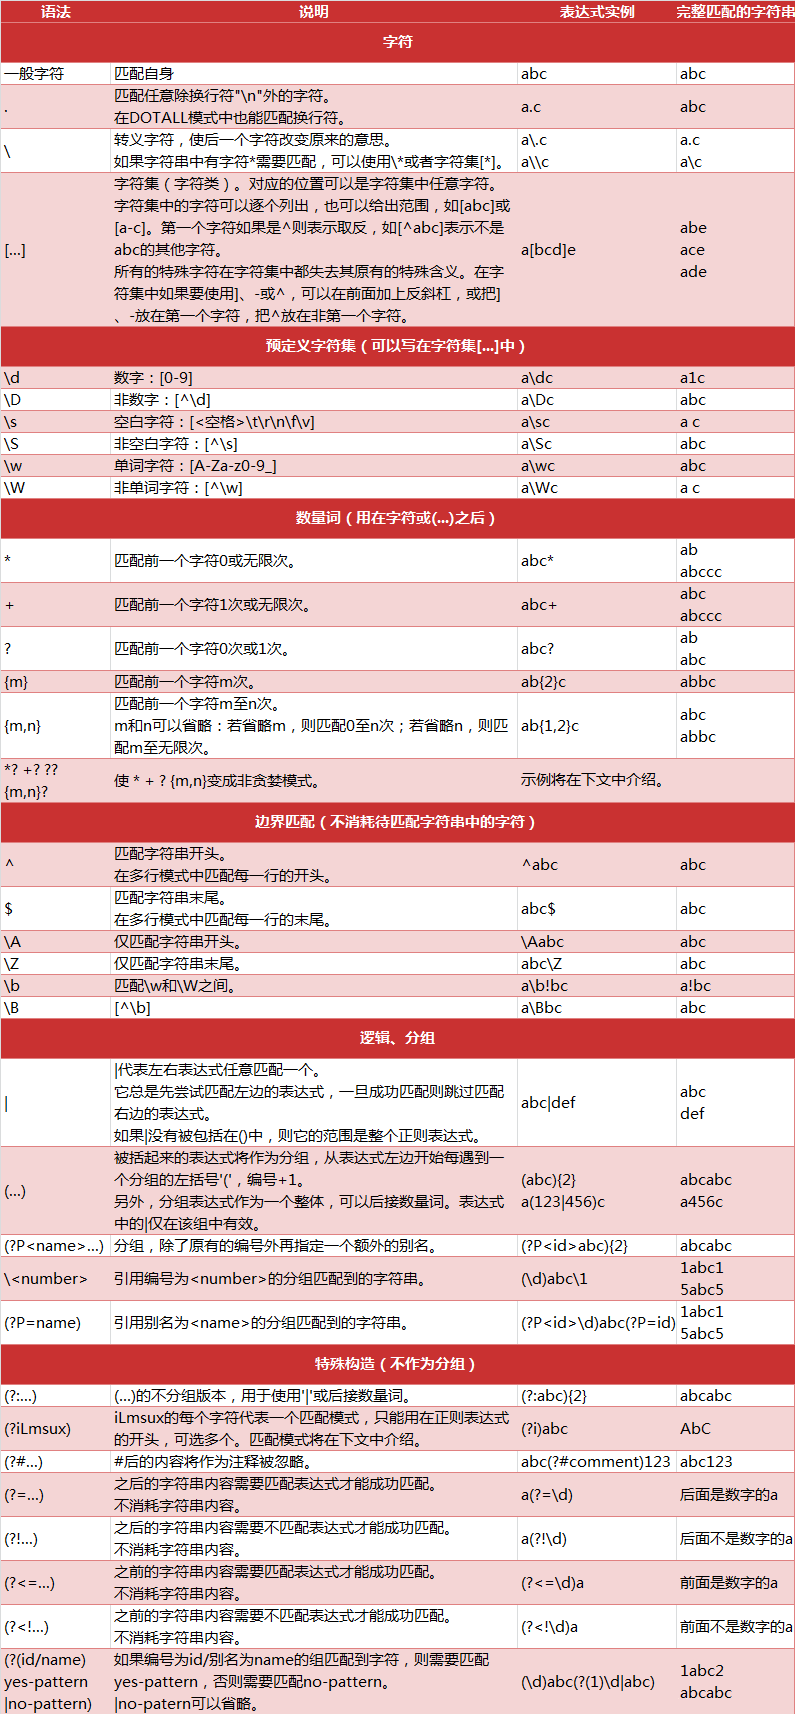
玩转python爬虫之正则表达式

玩转python爬虫之正则表达式

面对大量杂乱的代码夹杂文字我们怎样把它提取出来整理呢?下面就开始介绍一个十分强大的工具,正则表达式! 1.了解正则表达式 正则表达式是对字符串操作的一种逻辑公式,就是用事先定义好的一些特...

教你用python3根据关键词爬取百度百科的内容

前言 关于python版本,我一开始看很多资料说python2比较好,因为很多库还不支持3,但是使用到现在为止觉得还是pythin3比较好用,因为编码什么的问题,觉得2还是没有3方便。而...