Python使用爬虫猜密码
我们可以通过python 来实现这样一个简单的爬虫猜密码功能。下面就看看如何使用python来实现这样一个功能。
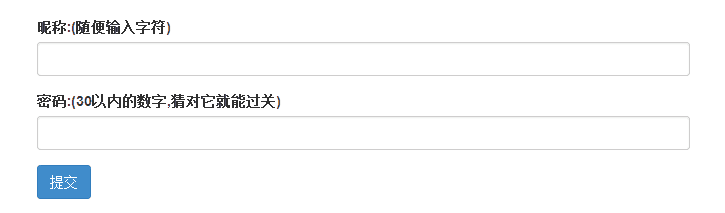
这里我们知道用户的昵称为:heibanke
密码是30以内的一个数字,要使用requests库循环提交来猜密码
主要需要用到的库是requests库
安装requests库
复制代码 代码如下:
pip install requests
要使用到的request库的功能是表单的提交
复制代码 代码如下:
requests.post(url,data)#通过post()语言向网址url发生data
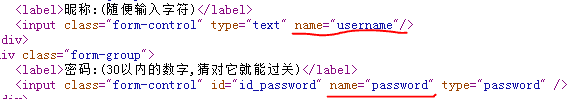
首先查看网页源码,找到需要提交的内容的参数名称
复制代码 代码如下:
可以看到需要提交的昵称的name=“username”,密码的name=“password”
requests传入网址的data中中需要包含这两个参数
url = "http://www.heibanke.com/lesson/crawler_ex01/"
params = {'username':'heibanke','password': str(password)}
r = requests.post(url,data=params)
建立循环,密码从1开始猜,不对就+1,直至猜中。
关键在于如何判断猜错了没?
首先看看猜错了的显示:
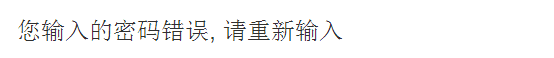
我们可以读取出该页面的文字,检测文字中有没有"错误"二字,有就代表提交的密码错误,没有就表示正确。要实现此功能,需要用到find()函数
find()函数介绍:
函数原型:find(str, pos_start, pos_end)
解释:
•str:被查找“字串”
•pos_start:查找的首字母位置(从0开始计数。默认:0)
•pos_end: 查找的末尾位置(默认-1)
返回值:如果查到:返回查找的第一个出现的位置。否则,返回-1。
example:
str = "0123"
print str.find("2",1,-1) #2
print str.find("1") #0,首次出现的位置
完整程序:
import requests
password=0
while True:
url = "http://www.heibanke.com/lesson/crawler_ex01/"
params = {'username':'heibanke','password': str(password)}
r = requests.post(url,data=params)
if r.text.find(u"错误")>0:#判断某次输入是否正确
password=password+1
else:
print password#,最后打印出password为6,居然输入06,006,0006都是对的
break
运行结果password为6