Python爬取三国演义的实现方法
本文的爬虫教程分为四部:
1.从哪爬 where
2.爬什么 what
3.怎么爬 how
4.爬了之后信息如何保存 save
一、从哪爬
二、爬什么
三国演义全文
三、怎么爬
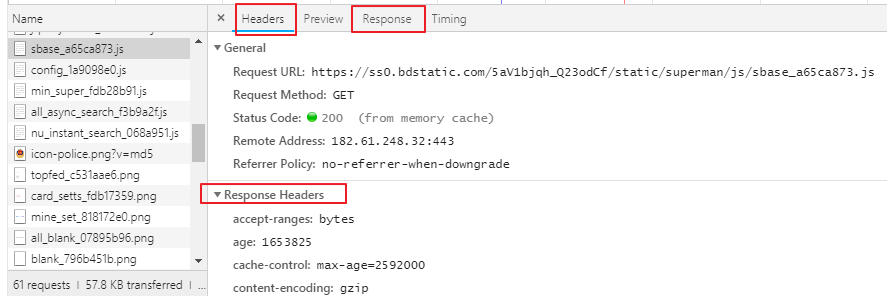
在Chrome页面打开F12,就可以发现文章内容在节点
<div id="con" class="bookyuanjiao">
只要找到这个节点,然后把内容写入到一个html文件即可。
content = soup.find("div", {"class": "bookyuanjiao", "id": "con"})
四、爬了之后如何保存
主要就是拿到内容,拼接到一个html文件,然后保存下来就可以了。
#!usr/bin/env
# -*-coding:utf-8 -*-
import urllib2
import os
from bs4 import BeautifulSoup as BS
import locale
import sys
from lxml import etree
import re

reload(sys)
sys.setdefaultencoding('gbk')

sub_folder = os.path.join(os.getcwd(), "sanguoyanyi")
if not os.path.exists(sub_folder):
  os.mkdir(sub_folder)

path = sub_folder

# customize html as head of the articles
input = open(r'0.html', 'r')
head = input.read()

domain = 'http://www.shicimingju.com/book/sanguoyanyi.html'
t = domain.find(r'.html')
new_domain = '/'.join(domain.split("/")[:-2])
first_chapter_url = domain[:t] + "/" + str(1) + '.html'
print first_chapter_url

# Get url if chapter lists
req = urllib2.Request(url=domain)
resp = urllib2.urlopen(req)
html = resp.read()
soup = BS(html, 'lxml')
chapter_list = soup.find("div", {"class": "bookyuanjiao", "id": "mulu"})
sel = etree.HTML(str(chapter_list))
result = sel.xpath('//li/a/@href')

for each_link in result:
  each_chapter_link = new_domain + "/" + each_link
  print each_chapter_link
  req = urllib2.Request(url=each_chapter_link)
  resp = urllib2.urlopen(req)
  html = resp.read()

  soup = BS(html, 'lxml')
  content = soup.find("div", {"class": "bookyuanjiao", "id": "con"})
  title = soup.title.text
  title = title.split(u'_《三国演义》_诗词名句网')[0]

  html = str(content)
  html = head + html + "</body></html>"

  filename = path + "\\" + title + ".html"
  print filename
  # write file
  output = open(filename, 'w')
  output.write(html)
  output.close()
0.html的内容如下
<html><head><meta http-equiv="Content-Type" content="text/html; charset=utf-8"></head><body>
总结
以上就是利用Python爬取三国演义的实现方法,希望对大家学习python能有所帮助,如果有疑问大家可以留言交流。