使用Python的Scrapy框架十分钟爬取美女图

yipeiwu_com7年前Python爬虫

简介

scrapy 是一个 python 下面功能丰富、使用快捷方便的爬虫框架。用 scrapy 可以快速的开发一个简单的爬虫,官方给出的一个简单例子足以证明其强大:
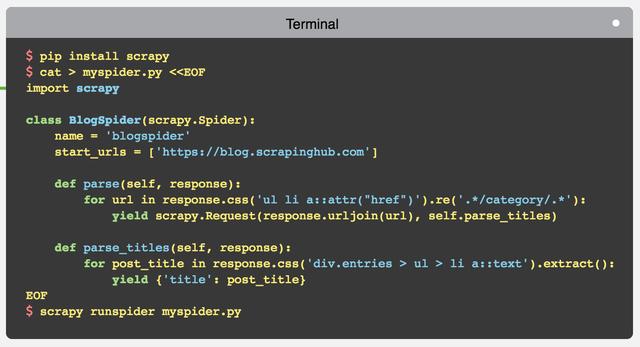
快速开发

下面开始10分钟倒计时:

当然开始前,可以先看看之前我们写过的 scrapy 入门文章 《零基础写python爬虫之使用Scrapy框架编写爬虫

1. 初始化项目

scrapy startproject mzt
cd mzt
scrapy genspider meizitu meizitu.com

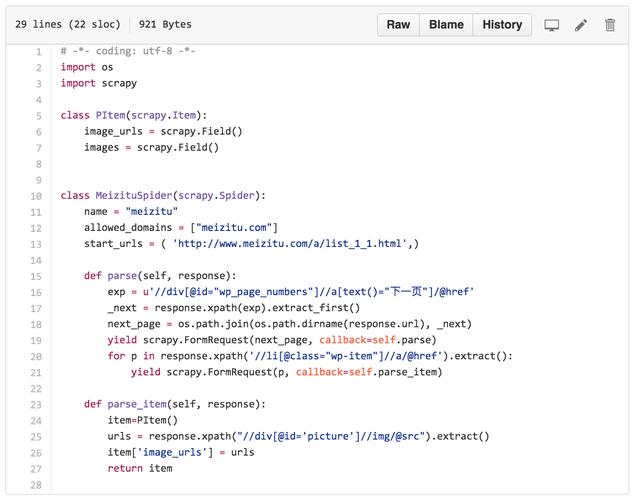
2. 添加 spider 代码:

定义 scrapy.Item ,添加 image_urls 和 images ,为下载图片做准备。

修改 start_urls 为初始页面, 添加 parse 用于处理列表页, 添加 parse_item 处理项目页面。
3. 修改配置文件:

DOWNLOAD_DELAY = 1 # 添加下载延迟配置
ITEM_PIPELINES = {'scrapy.pipelines.images.ImagesPipeline': 1} # 添加图片下载 pipeline
IMAGES_STORE = '.' # 设置图片保存目录

4. 运行项目:

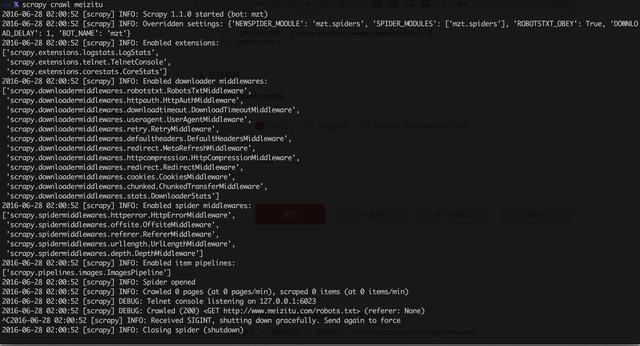
scrapy crawl meizitu

看,项目运行效果图
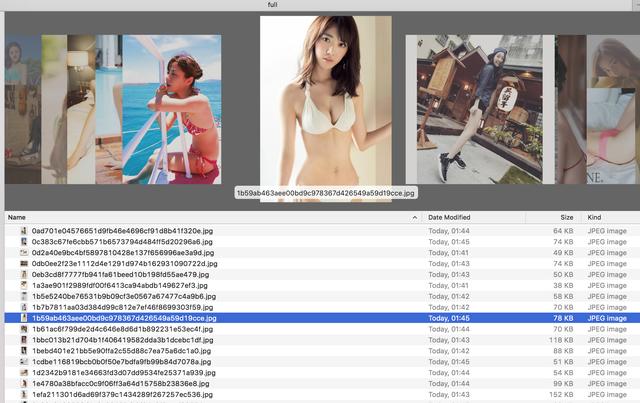
等待一会儿,就是收获的时候了

总结

以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流。
相关文章

python爬虫入门教程--HTML文本的解析库BeautifulSoup(四)

前言 python爬虫系列文章的第3篇介绍了网络请求库神器 Requests ,请求把数据返回来之后就要提取目标数据,不同的网站返回的内容通常有多种不同的格式,一种是 json 格式,这...

Python代理IP爬虫的新手使用教程

Python代理IP爬虫的新手使用教程

前言 Python爬虫要经历爬虫、爬虫被限制、爬虫反限制的过程。当然后续还要网页爬虫限制优化,爬虫再反限制的一系列道高一尺魔高一丈的过程。爬虫的初级阶段,添加headers和ip代理可...

python爬虫系列Selenium定向爬取虎扑篮球图片详解

python爬虫系列Selenium定向爬取虎扑篮球图片详解

前言: 作为一名从小就看篮球的球迷,会经常逛虎扑篮球及湿乎乎等论坛,在论坛里面会存在很多精美图片,包括NBA球队、CBA明星、花边新闻、球鞋美女等等,如果一张张右键另存为的话真是手都点...

Python HTML解析模块HTMLParser用法分析【爬虫工具】

本文实例讲述了Python HTML解析模块HTMLParser用法。分享给大家供大家参考,具体如下: 简介 先简略介绍一下。实际上,HTMLParser是python用来解析HTML的...

Python使用Selenium爬取淘宝异步加载的数据方法

淘宝的页面很复杂,如果使用分析ajax或者js的方式,很麻烦 抓取淘宝‘美食'上面的所有食品信息 spider.py #encoding:utf8 import re from s...