python urllib爬取百度云连接的实例代码
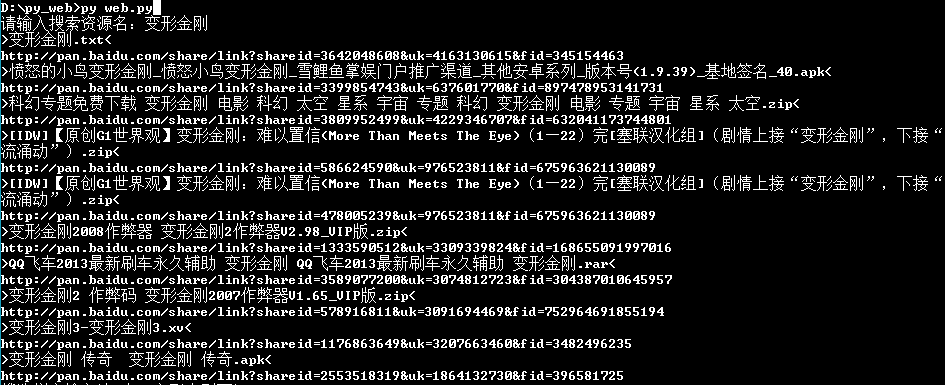
翻看自己以前写的程序,发现写过一个爬取盘多多百度云资源的东西,完全是当时想看变形金刚才自己写的,而且当时第一次接触python大概写了有2天才搞出来这个程序,学习python语言,可以看得出来那时候的代码写的真的low。虽然现在也不怎么样,哈哈,一直学习中,不做过多解释,上图上代码,因为变量的声明是什么我自己也忘了(手动傲娇),连写入文件当时都不会哈哈哈哈哈哈哈哈,也不知道class中可以通过init初始化,唉学习python原来我学到了这么多东西,感谢python
from bs4 import BeautifulSoup
import urllib
import requests
import re

adr =[]

''''对搜素资源名字进行url编码'''
search_text =raw_input('请输入搜索资源名:')
search_text = search_text.decode('gbk')
search_text = search_text.encode('utf-8')
search_text = urllib.quote(search_text)


''''获取文件地址'''
home = urllib.urlopen('http://www.panduoduo.net/s/name/'+search_text)


'''获取百度云地址'''
def getbaidu(adr):
  for i in adr:
    url = urllib.urlopen('http://www.panduoduo.net'+i)
    bs = BeautifulSoup(url)
    bs1 = bs.select('.dbutton2')
    href = re.compile('http\%(\%|\d|\w|\/\/|\/|\.)*')
    b = href.search(str(bs1))
    name = str(bs.select('.center')).decode('utf-8')
    text1 = re.compile('\<h1\sclass\=\"center"\>[\d|\w|\D|\W]*\</h1\>')
    text2 = text1.search(name)
    rag1 = re.compile('\>[\d|\w|\D|\W]*\<')
    if text2:
      text3 = rag1.search(text2.group())
      if text3:
        print text3.group()
    if b:
      text = urllib.unquote(str(b.group())).decode('utf-8')
      print text

'''初始化'''
def init(adr):
  soup = BeautifulSoup(home)
  soup = soup.select('.row')
  pattern = re.compile('\/r\/\d+')
  for i in soup:
    i = str(i)
    adress = pattern.search(i)
    adress = adress.group()
    adr.append(adress)


print 'running---------'
init(adr)
getbaidu(adr)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。