快速查询Python文档方法分享

yipeiwu_com7年前Python基础

Pydoc本地HTML形式查看

我们在编写Python代码时,常常会去查询某些模块及函数的使用,会选择dir()及help()函数、或查看CHM格式的Python帮助文档、或查看Python对应文件的源码、或网上搜索等方式。

这边提供一个本地快速查询Python文档的方式:将pydoc文档以本地HTML形式来查看;不论是Python内建模块,还是你本机已下载的三方模块,都能查看得到,且能定位到你本机的文件地址。

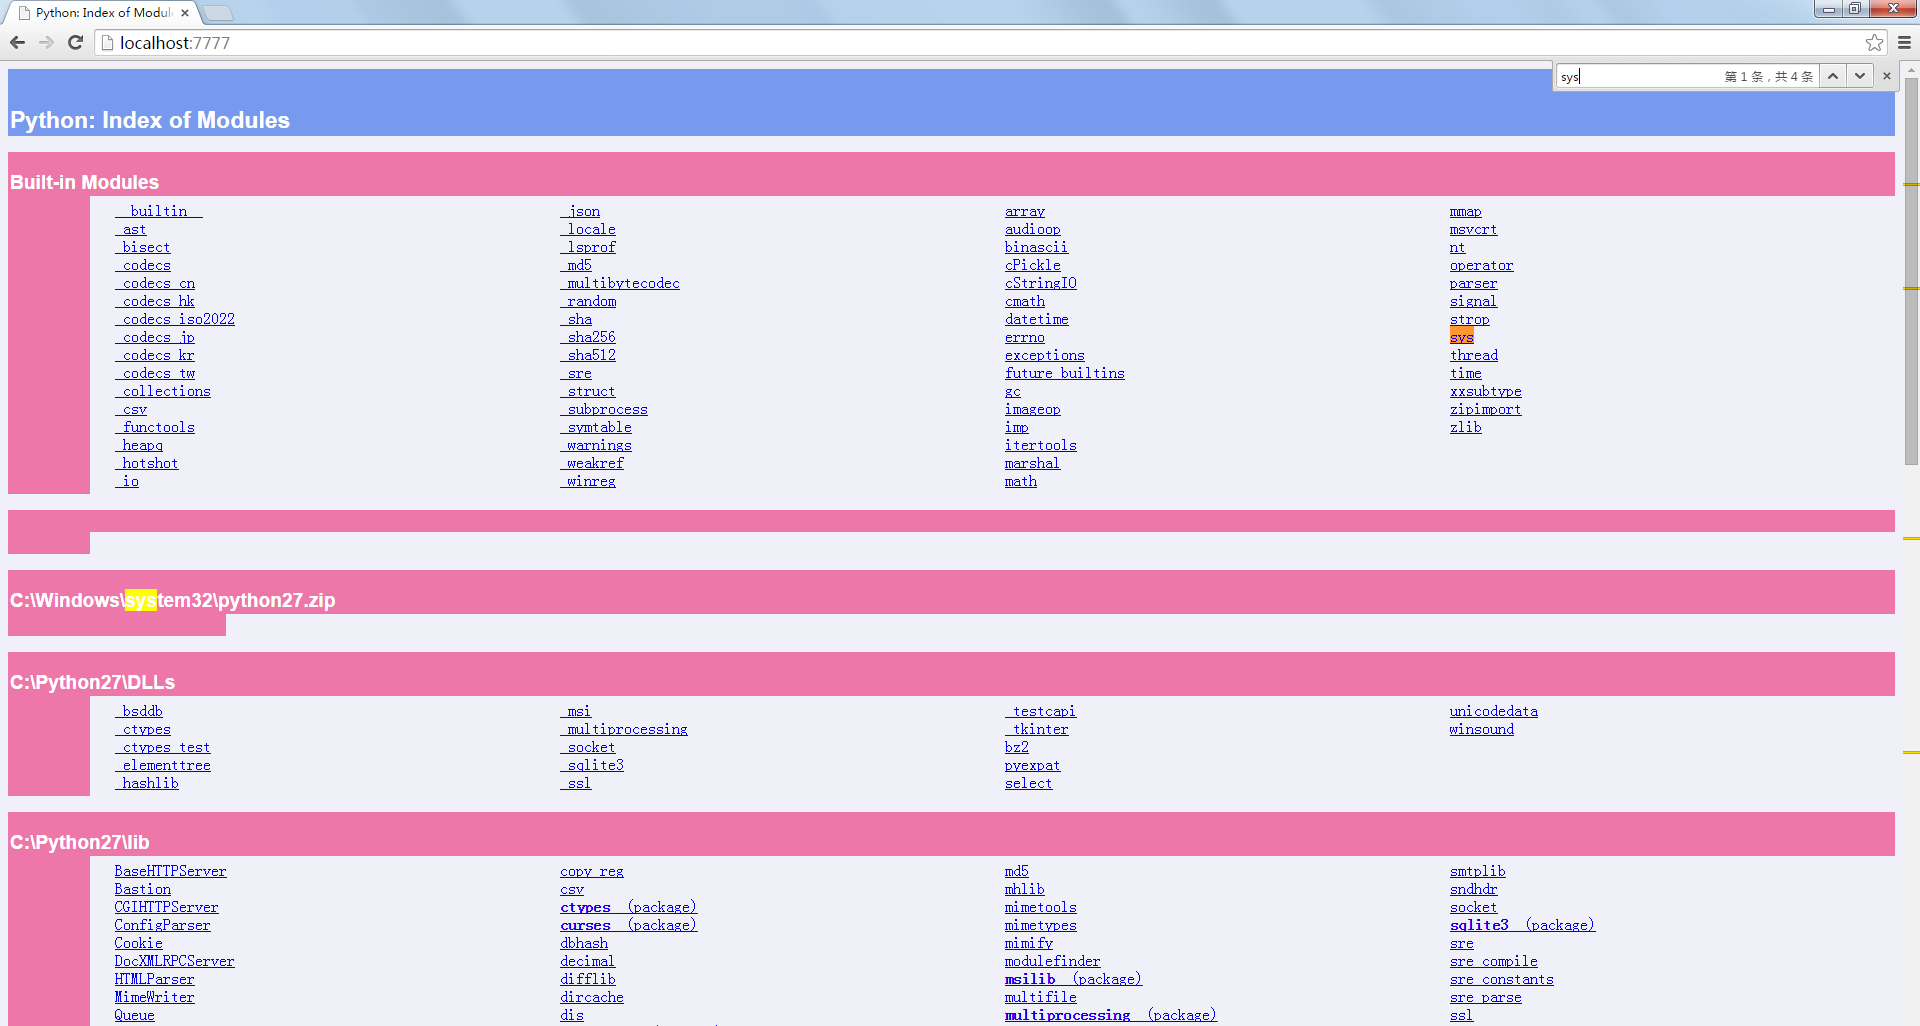
先来看下HTML页面的显示,首页如下,可使用浏览器CTRL+F搜索当前页面,快速定位到你要查询的模块。
下面说下具体实现方式,其实很容易。CMD 窗口,DOS下输入命令行 python -m pydoc -p 7777
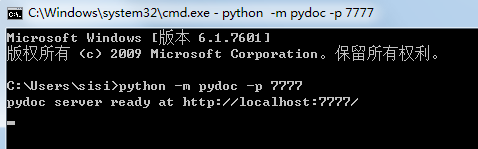
7777为本机端口号,也可改成其他端口号;然后浏览器中访问http://localhost:{端口号}/,如http://localhost:7777/即可

你也可以把该命令行写成批处理格式bat方便快速启动。

总结

以上就是本文关于本地快速查询Python文档方法分享的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站其他相关专题,如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
相关文章

pandas修改DataFrame列名的实现方法

提出问题 存在一个名为dataset的DataFrame >>> dataset.columns Index(['age', 'job', 'marital',...

matplotlib实现区域颜色填充

matplotlib实现区域颜色填充

本文实例为大家分享了matplotlib实现区域颜色填充的具体代码,供大家参考,具体内容如下 import matplotlib.pyplot as plt import nump...

Python.append()与Python.expand()用法详解

如下所示: alist=[1,2]] >>>[1,2] alist.append([3,4]) >>>[1, 2, [3, 4]] alist...

Pycharm+Scrapy安装并且初始化项目的方法

Pycharm+Scrapy安装并且初始化项目的方法

前言 Scrapy是一个开源的网络爬虫框架,Python编写的。最初设计用于网页抓取,也可以用来提取数据使用API或作为一个通用的网络爬虫。是数据采集不可必备的利器。 安装 pip...

python双向链表原理与实现方法详解

本文实例讲述了python双向链表原理与实现方法。分享给大家供大家参考,具体如下: 双向链表 一种更复杂的链表是“双向链表”或“双面链表”。每个节点有两个链接:一个指向前一个节点,当此节...