python PyTorch参数初始化和Finetune
前言
这篇文章算是论坛PyTorch Forums关于参数初始化和finetune的总结,也是我在写代码中用的算是“最佳实践”吧。最后希望大家没事多逛逛论坛,有很多高质量的回答。
参数初始化
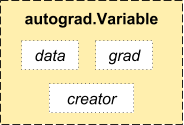
参数的初始化其实就是对参数赋值。而我们需要学习的参数其实都是Variable,它其实是对Tensor的封装,同时提供了data,grad等借口,这就意味着我们可以直接对这些参数进行操作赋值了。这就是PyTorch简洁高效所在。
所以我们可以进行如下操作进行初始化,当然其实有其他的方法,但是这种方法是PyTorch作者所推崇的:
def weight_init(m):
# 使用isinstance来判断m属于什么类型
  if isinstance(m, nn.Conv2d):
    n = m.kernel_size[0] * m.kernel_size[1] * m.out_channels
    m.weight.data.normal_(0, math.sqrt(2. / n))
  elif isinstance(m, nn.BatchNorm2d):
# m中的weight,bias其实都是Variable,为了能学习参数以及后向传播
    m.weight.data.fill_(1)
    m.bias.data.zero_()
Finetune
往往在加载了预训练模型的参数之后,我们需要finetune模型,可以使用不同的方式finetune。
局部微调
有时候我们加载了训练模型后,只想调节最后的几层,其他层不训练。其实不训练也就意味着不进行梯度计算,PyTorch中提供的requires_grad使得对训练的控制变得非常简单。
model = torchvision.models.resnet18(pretrained=True)
for param in model.parameters():
  param.requires_grad = False
# 替换最后的全连接层, 改为训练100类
# 新构造的模块的参数默认requires_grad为True
model.fc = nn.Linear(512, 100)

# 只优化最后的分类层
optimizer = optim.SGD(model.fc.parameters(), lr=1e-2, momentum=0.9)
全局微调
有时候我们需要对全局都进行finetune,只不过我们希望改换过的层和其他层的学习速率不一样,这时候我们可以把其他层和新层在optimizer中单独赋予不同的学习速率。比如:
ignored_params = list(map(id, model.fc.parameters()))
base_params = filter(lambda p: id(p) not in ignored_params,
           model.parameters())

optimizer = torch.optim.SGD([
      {'params': base_params},
      {'params': model.fc.parameters(), 'lr': 1e-3}
      ], lr=1e-2, momentum=0.9)
其中base_params使用1e-3来训练,model.fc.parameters使用1e-2来训练,momentum是二者共有的。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。