python多进程提取处理大量文本的关键词方法
经常需要通过python代码来提取文本的关键词,用于文本分析。而实际应用中文本量又是大量的数据,如果使用单进程的话,效率会比较低,因此可以考虑使用多进程。
python的多进程只需要使用multiprocessing的模块就行,如果使用大量的进程就可以使用multiprocessing的进程池--Pool,然后不同进程处理时使用apply_async函数进行异步处理即可。
实验测试语料:message.txt中存放的581行文本,一共7M的数据,每行提取100个关键词。
代码如下:
#coding:utf-8
import sys
reload(sys)
sys.setdefaultencoding("utf-8")
from multiprocessing import Pool,Queue,Process
import multiprocessing as mp
import time,random
import os
import codecs
import jieba.analyse
jieba.analyse.set_stop_words("yy_stop_words.txt")
def extract_keyword(input_string):
	#print("Do task by process {proc}".format(proc=os.getpid()))
	tags = jieba.analyse.extract_tags(input_string, topK=100)
	#print("key words:{kw}".format(kw=" ".join(tags)))
	return tags
#def parallel_extract_keyword(input_string,out_file):
def parallel_extract_keyword(input_string):
	#print("Do task by process {proc}".format(proc=os.getpid()))
	tags = jieba.analyse.extract_tags(input_string, topK=100)
	#time.sleep(random.random())
	#print("key words:{kw}".format(kw=" ".join(tags)))
	#o_f = open(out_file,'w')
	#o_f.write(" ".join(tags)+"\n")
	return tags
if __name__ == "__main__":
	data_file = sys.argv[1]
	with codecs.open(data_file) as f:
		lines = f.readlines()
		f.close()

	out_put = data_file.split('.')[0] +"_tags.txt"
	t0 = time.time()
	for line in lines:
		parallel_extract_keyword(line)
		#parallel_extract_keyword(line,out_put)
		#extract_keyword(line)
	print("串行处理花费时间{t}".format(t=time.time()-t0))

	pool = Pool(processes=int(mp.cpu_count()*0.7))
	t1 = time.time()
	#for line in lines:
		#pool.apply_async(parallel_extract_keyword,(line,out_put))
	#保存处理的结果,可以方便输出到文件
	res = pool.map(parallel_extract_keyword,lines)
	#print("Print keywords:")
	#for tag in res:
		#print(" ".join(tag))
	pool.close()
	pool.join()
	print("并行处理花费时间{t}s".format(t=time.time()-t1))
运行:
python data_process_by_multiprocess.py message.txt
message.txt是每行是一个文档,共581行,7M的数据
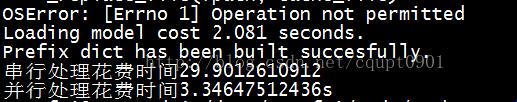
运行时间:
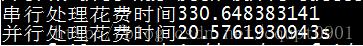
不使用sleep来挂起进程,也就是把time.sleep(random.random())注释掉,运行可以大大节省时间。
以上这篇python多进程提取处理大量文本的关键词方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。