python3第三方爬虫库BeautifulSoup4安装教程

yipeiwu_com7年前Python爬虫

Python3安装第三方爬虫库BeautifulSoup4,供大家参考,具体内容如下

在做Python3爬虫练习时,从网上找到了一段代码如下:

#使用第三方库BeautifulSoup,用于从html或xml中提取数据
from bs4 import BeautifulSoup

自己实践后,发现出现了错误,如下所示:
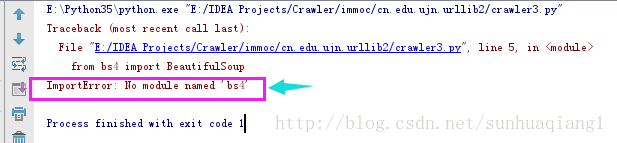
  

以上错误提示是说没有发现名为“bs4”的模块。即“bs4”模块未安装。   

进入Python安装目录,以作者IDE为例,


控制台提示第三方库BeautifulSoup4安装成功!回到之前的程序中,会发现IntelJ已经检测到第三方库BS4的安装,已自更新项目,此时项目恢复正常,无错误提示。

常见问题

在做BS4爬虫练习时,新建的文件名为bs4.py,结果出现如下错误提示:


即ImportError: cannot import name BeautifulSoup一般有一下几种情况:   

1. 在python2.x下安装的BeautifulSoup在python3.x下运行会报这种错,可用pip3 install Beautifulsoup4 .   

2. 导入时指定bs4 像这样: from bs4 import BeautifulSoup.   

3. 太巧合,如果你测试的文件名正好命名为bs4.py,那怎么整都会报这个错,把名字改成其他的吧。

附:BS4官方文档

以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

Python爬虫常用小技巧之设置代理IP

设置代理IP的原因 我们在使用Python爬虫爬取一个网站时,通常会频繁访问该网站。假如一个网站它会检测某一段时间某个IP的访问次数,如果访问次数过多,它会禁止你的访问。所以你可以设置...

python爬虫之urllib库常用方法用法总结大全

Urllib 官方文档地址:https://docs.python.org/3/library/urllib.html urllib提供了一系列用于操作URL的功能。 本文主要介绍的是...

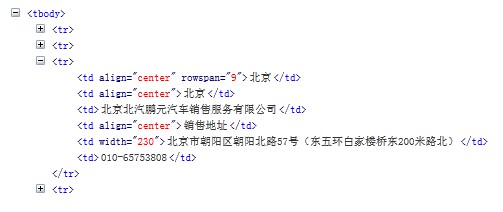
python抓取某汽车网数据解析html存入excel示例

python抓取某汽车网数据解析html存入excel示例

1、某汽车网站地址2、使用firefox查看后发现,此网站的信息未使用json数据,而是简单那的html页面而已 3、使用pyquery库中的PyQuery进行html的解析 页面样式:...

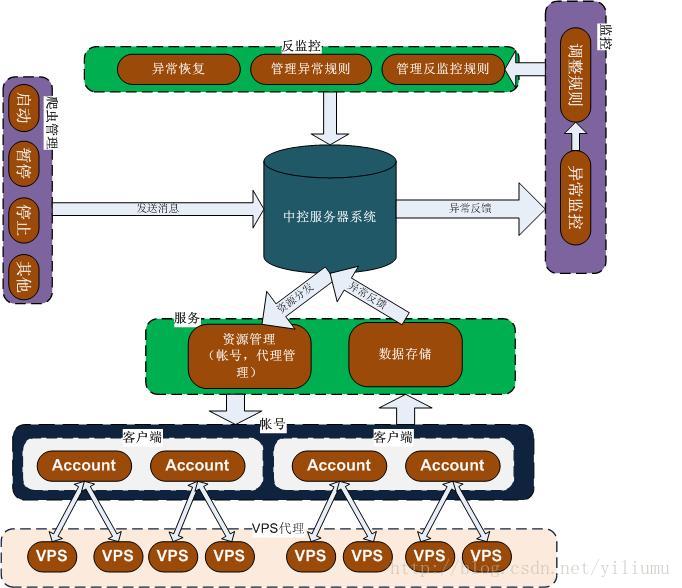
深入理解Python分布式爬虫原理

深入理解Python分布式爬虫原理

首先,我们先来看看,如果是人正常的行为,是如何获取网页内容的。 (1)打开浏览器,输入URL,打开源网页 (2)选取我们想要的内容,包括标题,作者,摘要,正文等信息 (3)存储到硬...

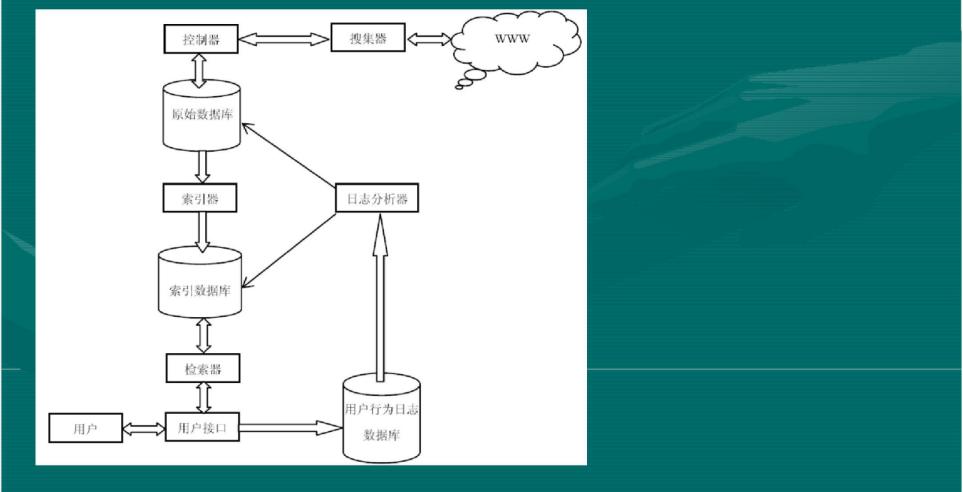
选择Python写网络爬虫的优势和理由

选择Python写网络爬虫的优势和理由

什么是网络爬虫? 网络爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成。传统爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过...