python+selenium打印当前页面的titl和url方法

yipeiwu_com7年前Python基础

dr.title //获取页面title

dr.current_url // 获取页面url

代码如下:

from selenium import webdriver

dr = webdriver.Firefox()
url = 'http://www.baidu.com'
dr.get(url)
# 获取页面title
title = dr.title
# 获取页面url
url = dr.current_url
print title
print url
dr.quit()

以上这篇python+selenium打印当前页面的titl和url方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

利用Fn.py库在Python中进行函数式编程

尽管Python事实上并不是一门纯函数式编程语言,但它本身是一门多范型语言,并给了你足够的自由利用函数式编程的便利。函数式风格有着各种理论与实际上的好处(你可以在Python的文档中找到...

python redis 删除key脚本的实例

单机模式 代码片段 安装 pip install redis import redis r = redis.Redis(host='192.168.1.3', port=6188,d...

django ManyToManyField多对多关系的实例详解

django ManyToManyField多对多关系的实例详解

Django 的 ORM 有多种关系:一对一,多对一,多对多 各自定义的方式为 : 一对一: OneToOneField 多对一: ForeignKey 多对多: ManyToManyF...

解决Python安装时报缺少DLL问题【两种解决方法】

解决Python安装时报缺少DLL问题【两种解决方法】

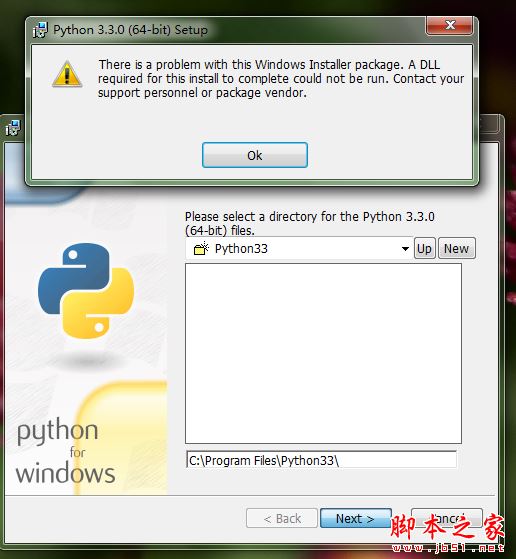
准备开始学习Python,但是刚准备环境搭建时就遇到了下面的错误: 仔细的看了看,说是缺少DLL。 对于这个问题的解决办法: 方法一: 1. 在安装包上点右键以管理员身份运行 2. C...

Python 调用 zabbix api的方法示例

前提准备: 1.使用python requests模块 2.了解json 3.zabbix api的具体调用建议先浏览一下官网 先上代码: import requests,json...