python爬虫获取百度首页内容教学

yipeiwu_com7年前Python爬虫

由传智播客教程整理,我们这里使用的是python2.7.x版本,就是2.7之后的版本,因为python3的改动略大,我们这里不用它。现在我们尝试一下url和网络爬虫配合的关系,爬浏览器首页信息。

1、首先我们创建一个urllib2_test01.py,然后输入以下代码:
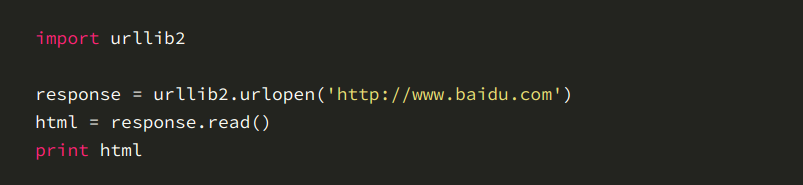
2、最简单的获取一个url的信息代码居然只需要4行,执行写的python代码:

3、之后我们会看到一下的结果

4、

实际上,如果我们在浏览器上打开网页主页的话,右键选择“查看源代码”,你会发现,跟我们刚打印出来的是一模一样的。也就是说,上面的4行代码就已经帮我们把百度的首页和全部代码爬了下来了 。

5、下面我们介绍一下这四行代码,第一行如下图,这个就是将urllib2组件进入进来,供给我们使用。

6、图片下面这步骤是调用urllib2库中的urlopen方法,该方法接受一个url地址,然后将请求后的得到的回应封装到一个叫respones对象当中。

7、最后这里,是调用response对象的read()方法,将请求的回应内容以字符串的形式给html变量。最后的print html就是将字符串打出来,所以说一个基本的url请求是对应的python代码是很简单的。

总结:以上就是关于利用python爬虫获取百度信息的步骤内容,感谢大家的学习和对【听图阁-专注于Python设计】的支持。

相关文章

解决python爬虫中有中文的url问题

解决python爬虫中有中文的url问题

如果URL中存在中文,而你却不对它做任何处理,他不会达到你所想的那样,因此我们需要将中文部分进行处理,要用到urllib.parse模块中的quote将中文转化成URL所需的编码,url...

Python爬虫之模拟知乎登录的方法教程

Python爬虫之模拟知乎登录的方法教程

前言 对于经常写爬虫的大家都知道,有些页面在登录之前是被禁止抓取的,比如知乎的话题页面就要求用户登录才能访问,而 “登录” 离不开 HTTP 中的 Cookie 技术。 登录原理 Coo...

python如何爬取网站数据并进行数据可视化

python如何爬取网站数据并进行数据可视化

前言 爬取拉勾网关于python职位相关的数据信息,并将爬取的数据已csv各式存入文件,然后对csv文件相关字段的数据进行清洗,并对数据可视化展示,包括柱状图展示、直方图展示、词云展示等...

Python常用爬虫代码总结方便查询

beautifulsoup解析页面 from bs4 import BeautifulSoup soup = BeautifulSoup(htmltxt, "lxml") # 三种装...

python实现爬虫抓取小说功能示例【抓取金庸小说】

python实现爬虫抓取小说功能示例【抓取金庸小说】

本文实例讲述了python实现爬虫抓取小说功能。分享给大家供大家参考,具体如下: # -*- coding: utf-8 -*- from bs4 import BeautifulS...