Python爬虫 bilibili视频弹幕提取过程详解
两个重要点
1.获取弹幕的url是以 .xml 结尾
2.弹幕url的所需参数在视频url响应的 javascript 中
先看代码
import requests
from lxml import etree
import re
# 使用手机UA
headers = {
  "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 11_0 like Mac OS X) AppleWebKit/604.1.38 (KHTML, like Gecko) Version/11.0 Mobile/15A372 Safari/604.1"
}
# 视频url
video_url = "https://m.bilibili.com/video/av37834086.html"
html = requests.get(url=video_url, headers=headers).content.decode('utf-8')
# 获取弹幕url的参数
cid = re.findall(r"comment: '//comment.bilibili.com/' \+ (.*?) \+ '.xml',", html)
url = "https://comment.bilibili.com/" + cid[0] + ".xml"
print(url)
response = requests.get(url, headers=headers)
html = response.content
xml = etree.HTML(html)
# 提取数据
str_list = xml.xpath("//d/text()")
# 写入文件
with open('bibi_xuxubaobao.txt', 'w', encoding='utf-8') as f:
  for line in str_list:
    f.write(line)
    f.write('\n')
先找到弹幕的url,以.xml结尾,所以先找到这串数字所在的位置,并获取这串数字发起第二次请求

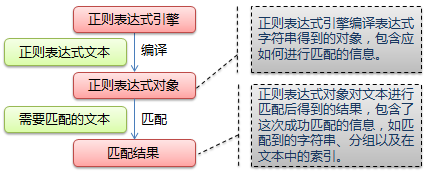
而这串数字就在 第一次请求的响应的JavaScript中,可以通过 re 正则表达式进行提取

接下来的工作就是获取弹幕url返回的所有弹幕数据,然后对响应进行数据处理。
代码示例中使用的是 lxml 进行获取。接着就是保存到个人本地文件中了
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。