pandas去重复行并分类汇总的实现方法
今天主要记录一下pandas去重复行以及如何分类汇总。以下面的数据帧作为一个例子:
import pandas as pd
data=pd.DataFrame({'产品':['A','A','A','A'],'数量':[50,50,30,30]})
pandas判断dataframe是否含有重复行数据用:df.duplicated()
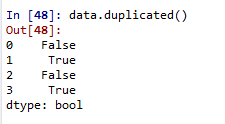
第一次出现的数据为False.重复的数据行就被记录为True。
去掉重复行数据使用data.drop_duplicates().
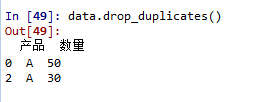
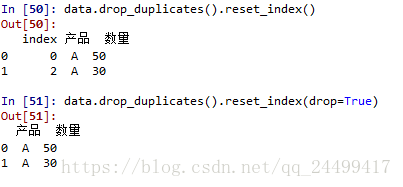
可以看到索引乱了,我们使用data.reset_index(),里面的参数drop=True,表明要舍掉原来的索引,不然的话原来的索引会保留下来。
分类汇总主要使用groupby(表明汇总的条件列)以及agg(要汇总的字段/列以及汇总的方式:求和还是最大最小值或者计数)。完整代码如下图
# -*- coding: utf-8 -*-
"""
Created on Fri Jul 20 09:08:10 2018
@author: FanXiaoLei
"""
import pandas as pd
data=pd.DataFrame({'产品':['A','A','A','A'],'数量':[50,50,30,30]})
if data.duplicated:
  dataA=data.drop_duplicates().reset_index(drop=True)
print(dataA)
dataB=dataA.groupby(by='产品').agg({'数量':sum})
print('数据汇总结果:')
print(dataB)
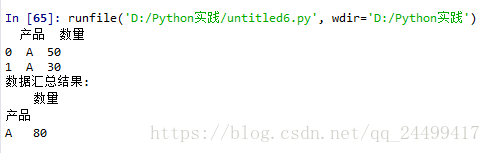
结果展示如下图:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。