Python爬虫——爬取豆瓣电影Top250代码实例
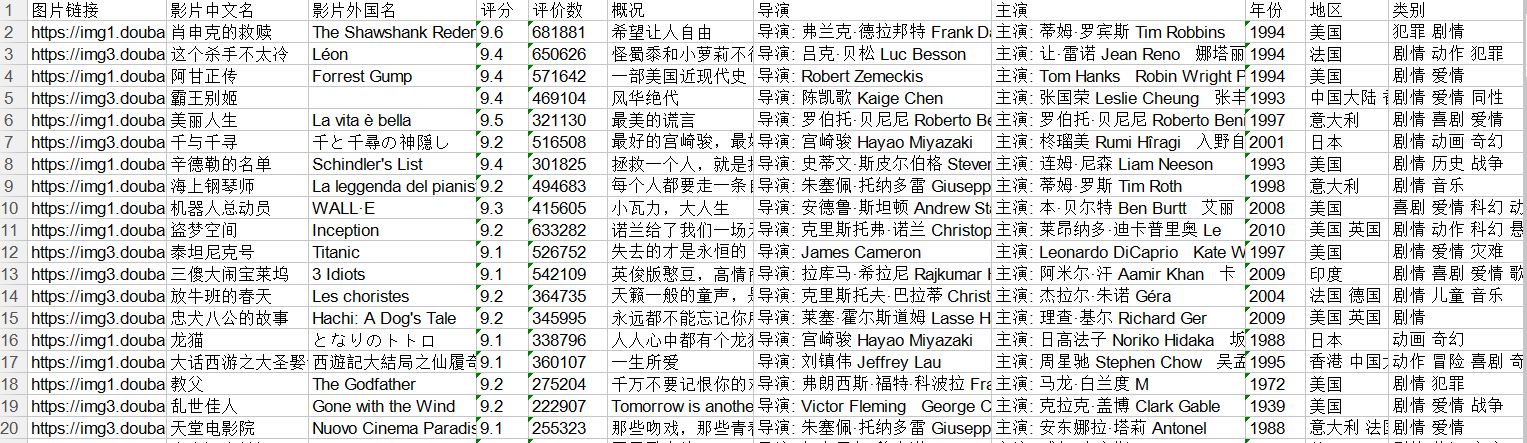
利用python爬取豆瓣电影Top250的相关信息,包括电影详情链接,图片链接,影片中文名,影片外国名,评分,评价数,概况,导演,主演,年份,地区,类别这12项内容,然后将爬取的信息写入Excel表中。基本上爬取结果还是挺好的。具体代码如下:
#!/usr/bin/python
#-*- coding: utf-8 -*-
import sys
reload(sys)
sys.setdefaultencoding('utf8')
from bs4 import BeautifulSoup
import re
import urllib2
import xlwt

#得到页面全部内容
def askURL(url):
  request = urllib2.Request(url)#发送请求
  try:
    response = urllib2.urlopen(request)#取得响应
    html= response.read()#获取网页内容
    #print html
  except urllib2.URLError, e:
    if hasattr(e,"code"):
      print e.code
    if hasattr(e,"reason"):
      print e.reason
  return html

#获取相关内容
def getData(baseurl):
  findLink=re.compile(r'<a href="(.*?)" rel="external nofollow" >')#找到影片详情链接
  findImgSrc=re.compile(r'<img.*src="(.*jpg)"',re.S)#找到影片图片
  findTitle=re.compile(r'<span class="title">(.*)</span>')#找到片名
  #找到评分
  findRating=re.compile(r'<span class="rating_num" property="v:average">(.*)</span>')
  #找到评价人数
  findJudge=re.compile(r'<span>(\d*)人评价</span>')
  #找到概况
  findInq=re.compile(r'<span class="inq">(.*)</span>')
  #找到影片相关内容:导演,主演,年份,地区,类别
  findBd=re.compile(r'<p class="">(.*?)</p>',re.S)
  #去掉无关内容
  remove=re.compile(r'              |\n|</br>|\.*')
  datalist=[]
  for i in range(0,10):
    url=baseurl+str(i*25)
    html=askURL(url)
    soup = BeautifulSoup(html, "html.parser")
    for item in soup.find_all('div',class_='item'):#找到每一个影片项
      data=[]
      item=str(item)#转换成字符串
      #print item
      link=re.findall(findLink,item)[0]
      data.append(link)#添加详情链接
      imgSrc=re.findall(findImgSrc,item)[0]
      data.append(imgSrc)#添加图片链接
      titles=re.findall(findTitle,item)
      #片名可能只有一个中文名,没有外国名
      if(len(titles)==2):
        ctitle=titles[0]
        data.append(ctitle)#添加中文片名
        otitle=titles[1].replace(" / ","")#去掉无关符号
        data.append(otitle)#添加外国片名
      else:
        data.append(titles[0])#添加中文片名
        data.append(' ')#留空
      rating=re.findall(findRating,item)[0]
      data.append(rating)#添加评分
      judgeNum=re.findall(findJudge,item)[0]
      data.append(judgeNum)#添加评论人数
      inq=re.findall(findInq,item)
      #可能没有概况
      if len(inq)!=0:
        inq=inq[0].replace("。","")#去掉句号
        data.append(inq)#添加概况
      else:
        data.append(' ')#留空
      bd=re.findall(findBd,item)[0]
      bd=re.sub(remove,"",bd)
      bd=re.sub('<br>'," ",bd)#去掉<br>
      bd=re.sub('/'," ",bd)#替换/
      #data.append(bd)
      words=bd.split(" ")
      for s in words:
        if len(s)!=0 and s!=' ':#去掉空白内容
           data.append(s)
      #主演有可能因为导演内容太长而没有
      if(len(data)!=12):
        data.insert(8,' ')#留空
      datalist.append(data)
  return datalist

#将相关数据写入excel中
def saveData(datalist,savepath):
  book=xlwt.Workbook(encoding='utf-8',style_compression=0)
  sheet=book.add_sheet('豆瓣电影Top250',cell_overwrite_ok=True)
  col=('电影详情链接','图片链接','影片中文名','影片外国名',
        '评分','评价数','概况','导演','主演','年份','地区','类别')
  for i in range(0,12):
    sheet.write(0,i,col[i])#列名
  for i in range(0,250):
    data=datalist[i]
    for j in range(0,12):
      sheet.write(i+1,j,data[j])#数据
  book.save(savepath)#保存

def main():
  baseurl='https://movie.douban.com/top250?start='
  datalist=getData(baseurl)
  savapath=u'豆瓣电影Top250.xlsx'
  saveData(datalist,savapath)

main()
Excel表部分内容如下:
以上所述是小编给大家介绍的Python爬取豆瓣电影Top250实例详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!