基于Python的Post请求数据爬取的方法详解
为什么做这个
和同学聊天,他想爬取一个网站的post请求
观察
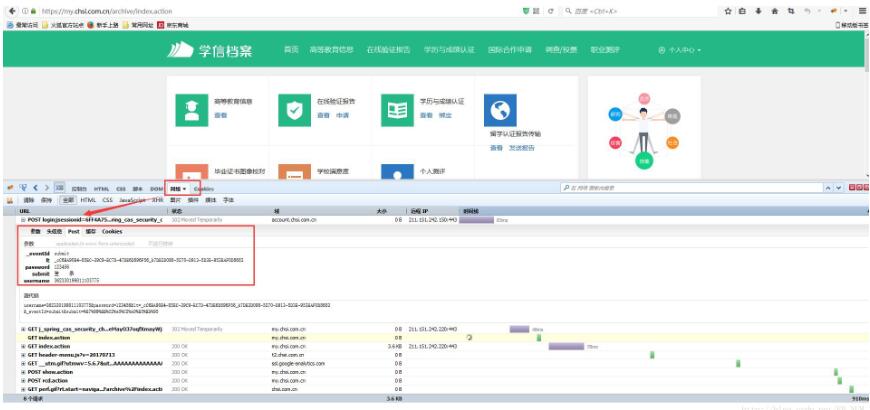
该网站的post请求参数有两种类型:(1)参数体放在了query中,即url拼接参数(2)body中要加入一个空的json对象,关于为什么要加入空的json对象,猜测原因为反爬虫。既有query参数又有空对象体的body参数是一件脑洞很大的事情。
一开始先在 apizza网站 上了做了相关实验才发现上面这个规律的,并发现该网站的请求参数要为raw形式,要是直接写代码找规律不是一件容易的事情。
源码
import requests
import json
headers = {
    'Accept':'application/json, text/javascript, */*; q=0.01',
    'X-Requested-With':'XMLHttpRequest',
    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.71 Safari/537.36',
    'Content-Type':'application/json',
    'Accept-Encoding':'gzip, deflate',
    'Accept-Language':'zh-CN,zh;q=0.8',
    'Cache-Control':'no-cache',
  }
#空的对象,body参数
data = {}
data = json.dumps(data)
page = 0
url = '网站地址,后面为参数?param1=1¶m1='+str(page)
response = requests.post(url = url,data=data ,headers =headers )
print(response.url)
print(response.text)
总结
- 现在相关工具中发现现象
- 请求方式确定:post还是get或者其它
- 参数类型:form-data还是raw或者其它
- 参数位置:若是post请求,在query中还是body中,还是二者皆有
ps:python requests 发起http POST 请求
python requests 发起http POST 请求,带参数,带请求头:
#!/usr/bin/env python
# -*- coding: utf-8 -*-
import requests
import json
url = 'http://official-account/app/messages/group'
body = {"type": "text", "content": "测试文本", "tag_id": "20717"}
headers = {'content-type': "application/json", 'Authorization': 'APP appid = 4abf1a,token = 9480295ab2e2eddb8'}
#print type(body)
#print type(json.dumps(body))
# 这里有个细节,如果body需要json形式的话,需要做处理
# 可以是data = json.dumps(body)
response = requests.post(url, data = json.dumps(body), headers = headers)
# 也可以直接将data字段换成json字段,2.4.3版本之后支持
# response = requests.post(url, json = body, headers = headers)
# 返回信息
print response.text
# 返回响应头
print response.status_code
总结
以上所述是小编给大家介绍的基于Python的Post请求数据爬取的方法详解,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!
如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!