详解python 爬取12306验证码
一个简单的验证码爬取程序
本文介绍了在Python2.7环境下爬取网站验证码:
思路就是获取验证码对应的url,然后发起requst请求,读取该URL对应的内容,然后写入到一个本地文件,实现一个验证码的保存。大量下载可以把以上程序写入一个死循环
代码实现部分:
import ssl
import urllib2
i=1
import time
while(1):

 #不加的话,无法访问12306
  ssl._create_default_https_context = ssl._create_unverified_context
  # headers = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.95 Safari/537.36"}
  # req = urllib2.Request("http://211.87.155.19/(yfsvlfreem4d0b553vkfzfzt)/CheckCode.aspx", headers=headers)
  # https: // www.zhihu.com / captcha.gif?r = 1495351271125 & type = login
  req = urllib2.Request("https://kyfw.12306.cn/otn/passcodeNew/getPassCodeNew?module=login&rand=sjrand&0.7174227166135074")
  u=urllib2.urlopen(req)
  data = u.read()
  f = open("C:/Users/123/Desktop/4/"+str(i)+".jpg",'wb')
  print i
  # time.sleep(1)#有时需要加延时,以防被封。
  i=i+1
  f.write(data)
  f.close()
以下就是爬取的照片的截图
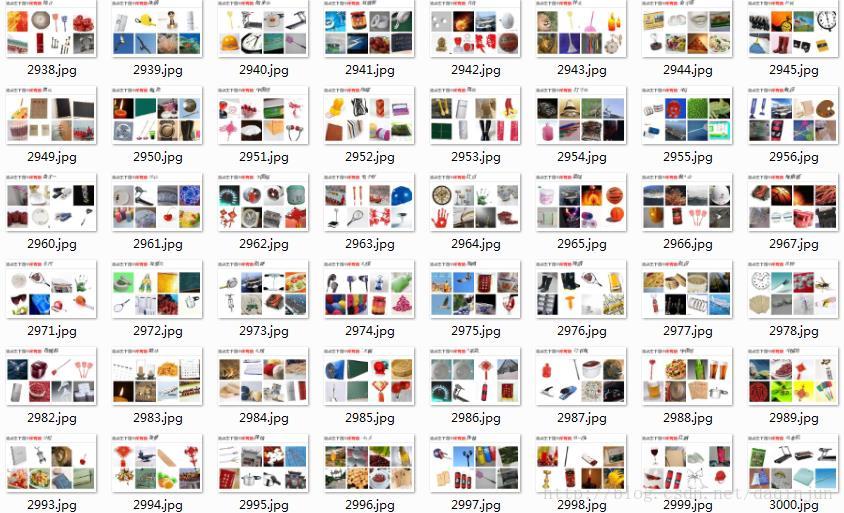
12306的验证码经常让人眼花缭乱,眼睛仔细看也不能100%的对,算是验证码中比较难是别的。一般由八幅图和一个问题组成,而且图片大小位置固定,问题的位置也是固定的,这也稍微降低了识别的难度。八幅图中一般有两幅图是同一物体,有一个和它比较像。不过有一点暂时没法确定,就是样本库到底有多大,或者说是到底有多少个类别,如果进行训练的话,我们必须获取每个类别个的一定数量的图片作为样本。
以上所述是小编给大家介绍的python爬取12306验证码详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!