Pandas DataFrame数据的更改、插入新增的列和行的方法
一、更改DataFrame的某些值
1、更改DataFrame中的数据,原理是将这部分数据提取出来,重新赋值为新的数据。
2、需要注意的是,数据更改直接针对DataFrame原数据更改,操作无法撤销,如果做出更改,需要对更改条件做确认或对数据进行备份。
代码:
import pandas as pd
df1 = pd.DataFrame([['Snow','M',22],['Tyrion','M',32],['Sansa','F',18],['Arya','F',14]], columns=['name','gender','age'])

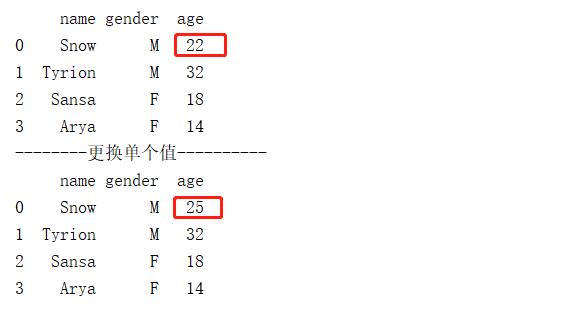
print("--------更换单个值----------")
# loc和iloc 可以更换单行、单列、多行、多列的值
df1.loc[0,'age']=25   # 思路:先用loc找到要更改的值,再用赋值(=)的方法实现更换值
df1.iloc[0,2]=25     # iloc:用索引位置来查找

# at 、iat只能更换单个值
df1.at[0,'age']=25   # iat 用来取某个单值,参数只能用数字索引
df1.iat[0,2]=25     # at 用来取某个单值,参数只能用index和columns索引名称
print(df1)
结果图:
二、插入新增列、行
代码:
import pandas as pd

df1 = pd.DataFrame([['Snow','M',22],['Tyrion','M',32],['Sansa','F',18],['Arya','F',14]], columns=['name','gender','age'])

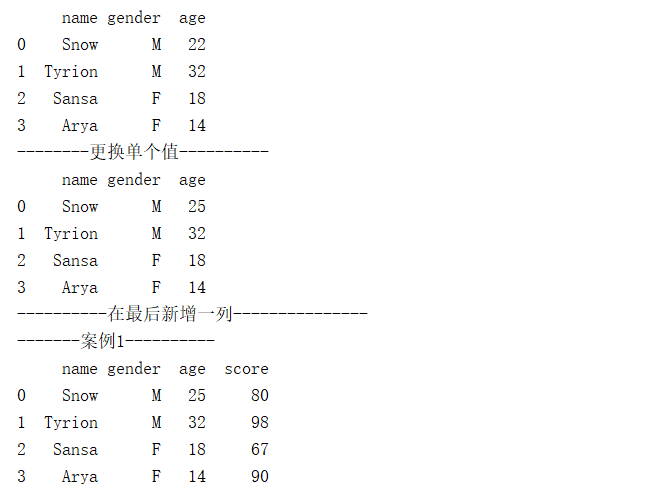
print("----------在最后新增一列---------------")
print("-------案例1----------")
# 在数据框最后加上score一列,元素值分别为:80,98,67,90
df1['score']=[80,98,67,90]  # 增加列的元素个数要跟原数据列的个数一样
print(df1)

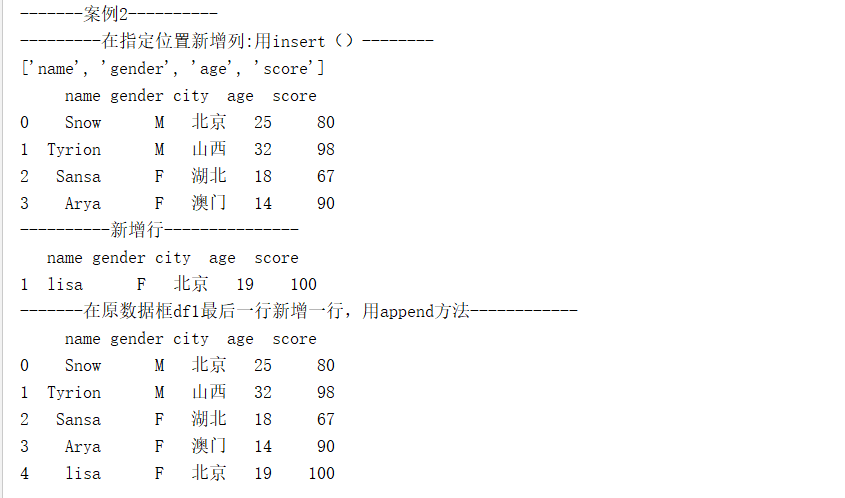
print("-------案例2----------")
print("---------在指定位置新增列:用insert()--------")
# 在gender后面加一列城市
# 在具体某个位置插入一列可以用insert的方法
# 语法格式:列表.insert(index, obj)
# index --->对象 obj 需要插入的索引位置。
# obj ---> 要插入列表中的对象(列名)

col_name=df1.columns.tolist()          # 将数据框的列名全部提取出来存放在列表里
print(col_name)

col_name.insert(2,'city')           # 在列索引为2的位置插入一列,列名为:city,刚插入时不会有值,整列都是NaN
df1=df1.reindex(columns=col_name)       # DataFrame.reindex() 对原行/列索引重新构建索引值

df1['city']=['北京','山西','湖北','澳门']  # 给city列赋值
print(df1)

print("----------新增行---------------")
# 重要!!先创建一个DataFrame,用来增加进数据框的最后一行
new=pd.DataFrame({'name':'lisa',
         'gender':'F',
         'city':'北京',
         'age':19,
         'score':100},
         index=[1])  # 自定义索引为:1 ,这里也可以不设置index
print(new)

print("-------在原数据框df1最后一行新增一行,用append方法------------")
df1=df1.append(new,ignore_index=True)  # ignore_index=True,表示不按原来的索引,从0开始自动递增
print(df1)
结果图:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。