Python二进制文件读取并转换为浮点数详解
本文所用环境:
Python 3.6.5 |Anaconda custom (64-bit)|
引言
由于某些原因,需要用python读取二进制文件,这里主要用到struct包,而这个包里面的方法主要是unpack、pack、calcsize。详细介绍可以看:Python Struct 官方文档。这里主要讨论,python二进制转浮点数的操作。
python中一个float类型的数占4个字节。
二进制数据转float,可以用struct.unpack()来实现。
小文件读取
较小的文件,可以一次读取:
首先导入所需的包:
import numpy as np
import struct
Python
例如:我需要读取一个名为filename,存放着形状为[100,1025]的浮点数的文件。可以采用以下办法
# 加载测试数据
f = open('filename','rb')
# 102500为文档中包含的数字个数,而一个浮点数占4个字节
data_raw = struct.unpack('f'*102500,f.read(4*102500))
f.close()
verify_data = np.asarray(verify_data_raw).reshape(-1,1025)
大文件处理方法
我需要处理的文件大小有38.1G,存放着[10000000,1025]大小的向量。
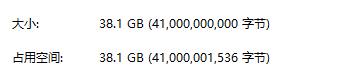
关于大文件的处理,我参考了这文章,但是,这个方法不能很好的将二进制文件转换成浮点数。
所以我想到了另外一种办法:
通过Linux命令切割文件
通过split命令将38.1G的文件按照指定大小切割,
split -b 820000k -a 2 filename data_
上述代码的意思是,指定每块大小为820000k,-a 2代表2位数命名,‘data_'代表前缀是'data_'
最终生成49个文件(字典序 aa – bw),前48个文件每个204800行 最后一个文件 169600行

通过python循环读取文件
首先构建词汇表:
voc = ['a','b','c','d','e','f','g','h','i','j','k','l',
'm','n','o','p','q','r','s','t','u','v','w','x',
'y','z']
voc_short = ['a','b','c','d','e','f','g','h','i','j','k','l',
'm','n','o','p','q','r','s','t','u','v']
为了方便读取,将49个二进制文件转换成numpy专用二进制格式*.npy
for i in voc:
data_name = 'data_a'+str(i)
f = open(data_name,'rb')
data_raw = struct.unpack('f'*209920000,f.read(4*209920000))
f.close()
data = np.asarray(data_raw).reshape(-1,1025)
np.save(data_name+'.npy',data) # 保存data_a*.npy文件
for i in voc_short:
data_name = 'data_b'+str(i)
f = open(data_name,'rb')
data_raw = struct.unpack('f'*209920000,f.read(4*209920000))
f.close()
data = np.asarray(data_raw).reshape(-1,1025)
np.save(data_name+'.npy',data) # 保存data_b*.npy文件
data_name = 'data_bw'
f = open(data_name,'rb')
data_raw = struct.unpack('f'*173840000,f.read(4*173840000))
np.save(data_name+'.npy',data_raw) # 保存data_bw.npy文件
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。

