python识别图像并提取文字的实现方法
前言
python图像识别一般基础到的就是tesseract了,在爬虫中处理验证码广泛使用。
安装
安装教程网上大都差不多,Windows下确实比较麻烦,涉及到各种路径、环境变量甚至与linux不同的路径分隔符,所以这里的安装是基于Centos7。
1. 依赖安装
yum install -y automake autoconf libtool gcc gcc-c++
2. 安装leptonica
Leptonica主要用于图像处理和图像分析
原则上所有的库文件都是可以直接用yum安装的,如果想要具体的某个版本,可以前往官方源下载对应版本然后按照对应方式编译
wget http://www.leptonica.org/source/leptonica-1.74.4.tar.gz
tar -zxvf leptonica-1.74.4.tar.gz
cd leptonica-1.74.4/
./configure
make && make install
3. 安装tesseract
其他各版本可以在这里下载并自行编译,也提供直接使用的文件。
yum install tesseract
4. 验证安装
tesseract --version
5. 语言包下载
前往tesseract-ocr/tessdata下载相应的语言包,然后将之移动到tessdata目录下,可以用whereis tesseract查看一下具体的目录,我的是/usr/share/tesseract/tessdata/mv *.traineddata /usr/local/share/tessdata/
6. 查看目前已下载的语言
tesseract --list-langs
使用
# tesseract
Usage:
 tesseract --help | --help-psm | --help-oem | --version
 tesseract --list-langs [--tessdata-dir PATH]
 tesseract --print-parameters [options...] [configfile...]
 tesseract imagename|stdin outputbase|stdout [options...] [configfile...]

OCR options:
 --tessdata-dir PATH  Specify the location of tessdata path.
 --user-words PATH   Specify the location of user words file.
 --user-patterns PATH Specify the location of user patterns file.
 -l LANG[+LANG]    Specify language(s) used for OCR.
 -c VAR=VALUE     Set value for config variables.
            Multiple -c arguments are allowed.
 --psm NUM       Specify page segmentation mode.
 --oem NUM       Specify OCR Engine mode.
NOTE: These options must occur before any configfile.
语法
tesseract imagename outputbase [-l lang] [-psm pagesegmode] [configfile...]
- imagename:图片名字
- outputbase:指定输出,如果希望直接输出而不是保存到文件,那么就使用 stdout,否则这个参数将会作为保存结果的文件的前缀
- -l指定语言文件,默认使用英文
- tesseract --print-parameters:查看更多参数信息
- 使用-c指定单项参数的值或者将配置写入配置文件放在命令最后(支持多个配置文件)
- psm 识别图像的方式
0:定向脚本监测(OSD)
1: 使用OSD自动分页
2 :自动分页,但是不使用OSD或OCR(Optical Character Recognition,光学字符识别)
3 :全自动分页,但是没有使用OSD(默认)
4 :假设可变大小的一个文本列。
5 :假设垂直对齐文本的单个统一块。
6 :假设一个统一的文本块。
7 :将图像视为单个文本行。
8 :将图像视为单个词。
9 :将图像视为圆中的单个词。
10 :将图像视为单个字符。
python中使用
Tesseract安装完成后可以很方便的被Python调用,但是需要pillow和pytesseract的支持。
python中转换
image_to_data(image, lang=None, config='', nice=0, output_type=Output.STRING)
- image Object,由Tesseract处理的图像的PIL Image/NumPy数组
- lang String,Tesseract语言代码字符串
- config String,任何其他配置字符串,例如:config='--psm 6'
- 语言文件可以叠加,用“+”隔开
- 我们也可以在这里进行tessdata路径的设置,跟在config里面即可
- 更多配置包括config和psm都和tesseract类似
实例:
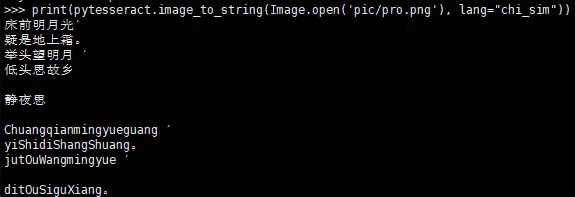
流程: 打开图片,配置,转换,可以通过Image的open或者cv2的imread打开图片,之后对图片进行对比度增强,降噪等处理,效果会好一些。
from PIL import Image
import pytesseract
class Languages:
  CHS = 'chi_sim'
  ENG = 'eng'
def img_to_str(image_path, lang=Languages.ENG):
  return pytesseract.image_to_string(Image.open(image_path), lang)
print(img_to_str('pic/numu.png', lang=Languages.ENG))
print(img_to_str('pic/pro.png', lang=Languages.ENG))

总结
简单的文本识别效果还是不错的,但是设计到多空行、符号等,识别效果就不是太好了,准确度方面可以通过对字库的训练达到想要的效果,之后对获取到的文本利用诸如re等各种库进行操作,其实应用还蛮广泛的。2. 但是它在验证码方面的话效果还是不错的,验证码的话tesserocr也是比较方面的.
识别中文可能会出现编码错误,这也是识别上的漏洞之一了,网上大佬们所说的改变文本的编码似乎并不能解决问题,所以对长文本图片处理还是不太建议直接转换。
图文处理也可以借鉴一些各平台的API,百度、腾讯、美团都有支持.
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。