Python爬虫动态ip代理防止被封的方法

yipeiwu_com7年前Python爬虫

在爬取的过程中难免发生ip被封和403错误等等,这都是网站检测出你是爬虫而进行反爬措施,在这里为大家总结一下怎么用IP代理防止被封

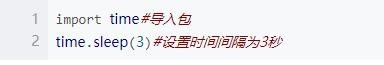
首先,设置等待时间:

常见的设置等待时间有两种,一种是显性等待时间(强制停几秒),一种是隐性等待时间(看具体情况,比如根据元素加载完成需要时间而等待)图1是显性等待时间设置,图2是隐性
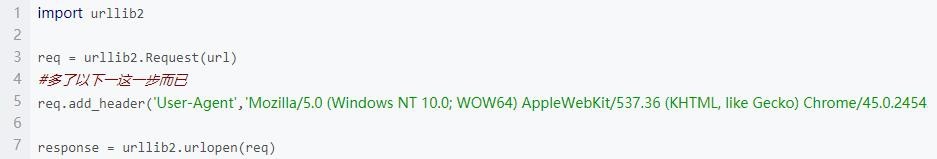
第二步,修改请求头:

识别你是机器人还是人类浏览器浏览的重要依据就是User-Agent,比如人类用浏览器浏览就会使这个样子的User-Agent:'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/45.0.2454.101 Safari/537.36'
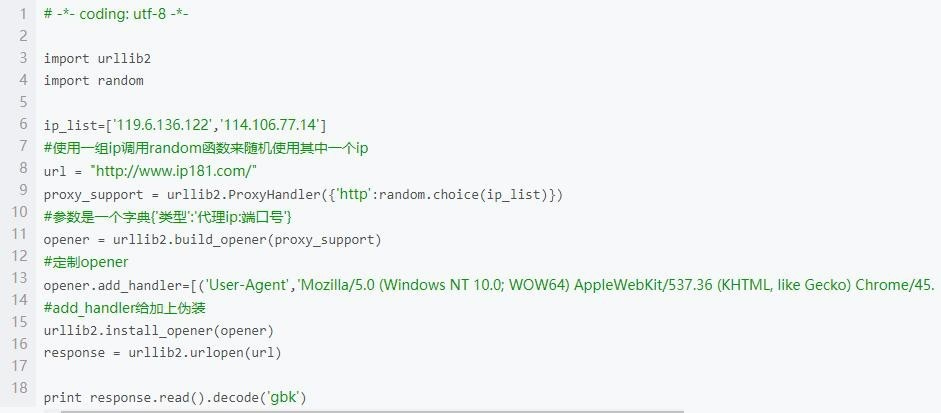
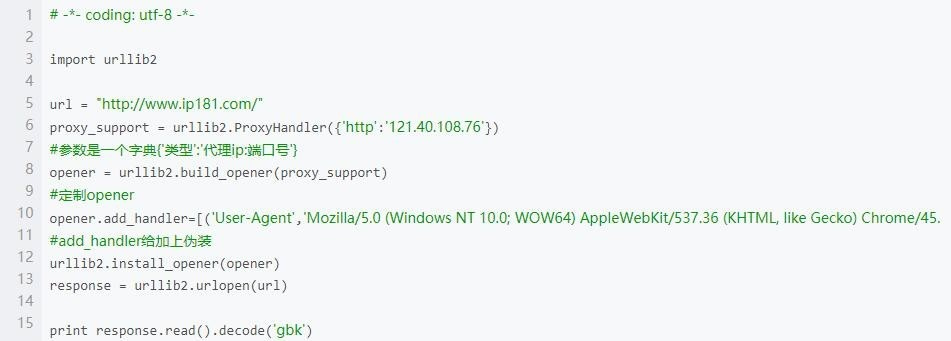
第三步,采用代理ip/建代理ip池

直接看代码。利用动态ip代理,可以强有力地保障爬虫不会被封,能够正常运行。图1为使用代理ip的情况,图2是建ip代理池的代码,有没有必要需要看自己的需求,大型项目是必须用大量ip的。
做好以上3个步骤,大致爬虫的运行就不成问题了。

以上就是本次介绍的全部内容,感谢大家的学习和对【听图阁-专注于Python设计】的支持。
相关文章

Python网络爬虫出现乱码问题的解决方法

关于爬虫乱码有很多各式各样的问题,这里不仅是中文乱码,编码转换、还包括一些如日文、韩文 、俄文、藏文之类的乱码处理,因为解决方式是一致的,故在此统一说明。 网络爬虫出现乱码的原因 源...

python爬虫 urllib模块反爬虫机制UA详解

python爬虫 urllib模块反爬虫机制UA详解

方法: 使用urlencode函数 urllib.request.urlopen() import urllib.request import urllib.parse url =...

python抓取京东价格分析京东商品价格走势

复制代码 代码如下:from creepy import Crawlerfrom BeautifulSoup import BeautifulSoupimport urllib2impo...

python实现爬虫统计学校BBS男女比例(一)

python实现爬虫统计学校BBS男女比例(一)

一、项目需求 前言:BBS上每个id对应一个用户,他们注册时候会填写性别(男、女、保密三选一)。 经过检查,BBS注册用户的id对应1-300000,大概是30万的用户 笔者想用Pyth...

python爬虫selenium和phantomJs使用方法解析

python爬虫selenium和phantomJs使用方法解析

1.selenum:三方库。可以实现让浏览器完成自动化的操作。 2.环境搭建 2.1 安装: pip install selenium 2.2 获取浏览器的驱动程序 下载地址...