使用python爬取B站千万级数据
Python(发音:英[?pa?θ?n],美[?pa?θɑ:n]),是一种面向对象、直译式电脑编程语言,也是一种功能强大的通用型语言,已经具有近二十年的发展历史,成熟且稳定。它包含了一组完善而且容易理解的标准库,能够轻松完成很多常见的任务。它的语法非常简捷和清晰,与其它大多数程序设计语言不一样,它使用缩进来定义语句。
Python支持命令式程序设计、面向对象程序设计、函数式编程、面向切面编程、泛型编程多种编程范式。与Scheme、Ruby、Perl、Tcl等动态语言一样,Python具备垃圾回收功能,能够自动管理存储器使用。它经常被当作脚本语言用于处理系统管理任务和网络程序编写,然而它也非常适合完成各种高级任务。Python虚拟机本身几乎可以在所有的作业系统中运行。使用一些诸如py2exe、PyPy、PyInstaller之类的工具可以将Python源代码转换成可以脱离Python解释器运行的程序。
粉丝独白
说起热门的B站相信很多喜欢玩动漫的,看最有创意的Up主的同学一定非常熟悉。我突发奇想学Python这么久了,为啥不用Python爬取B站中我关注的人,已经关注的人他们关注的人,看看全站里面热门的UP主都是是哪些。
要点:
- 爬取10万用户数据
- 数据存储
- 数据词云分析
1.准备阶段
写代码前先构思思路:既然我要爬取用户关注的用户,那我需要存储用户之间的关系,确定谁是主用户,谁是follower。
存储关系使用数据库最方便,也有利于后期的数据分析,我选择sqlite数据库,因为Python自带sqlite,sqlite在Python中使用起来也非常方便。
数据库中需要2个表,一个表存储用户的相互关注信息,另一个表存储用户的基本信息,在B站的用户体系中,一个用户的mid号是唯一的。
然后我还需要一个列表来存储所以已经爬取的用户,防止重复爬取,毕竟用户之间相互关注的现象也是存在的,列表中存用户的mid号就可以了。
2.新建数据库
先写建数据库的代码,数据库中放一个用户表,一个关系表:

3.爬取前5页的用户数据
我需要找到B站用户的关注列表的json接口,很快就找到了,地址是:
https://api.bilibili.com/x/relation/followings?vmid=2&pn=1&ps=20&order=desc&jsonp=jsonp&callback=__jp7
其中vimd=后的参数就是用户的mid号
pn=1指用户的关注的第一面用户,一面显示20个用户
因为B站的隐私设置,一个人只能爬取其他人的前5页关注,共100人。
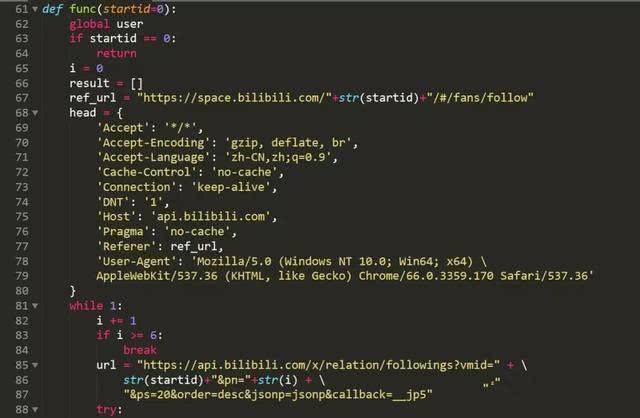
整个爬取页面的思路比较简单,首先设置header,用requests库进行API请求,获得关注的用户数据列表。
我们爬取前5页,每一页的数据进行简单的处理,然后转为字典数据进行获取mid,uname,sign3个维度的数据,最后save()函数存入db.
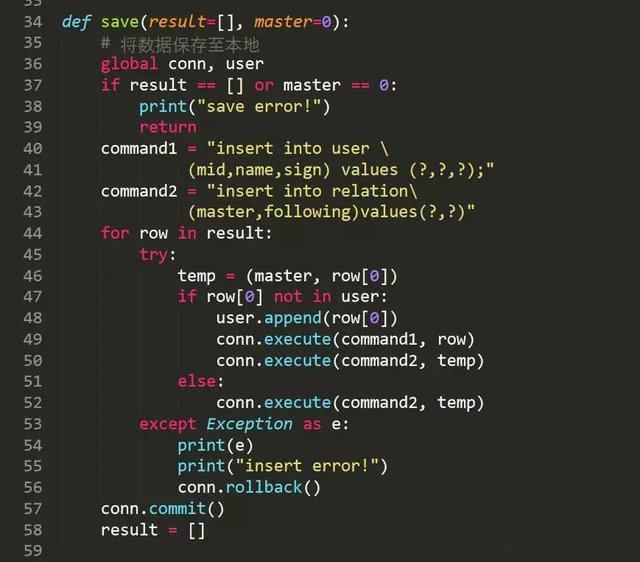
4.存入数据库
我们数据集里面一共有2个表,一个用户列表,用来存储所以的用户信息,一个是用户之间的关注信息。
5.探秘是热门UP主
打算利用已经爬取到本地的数据进行词云的生成,来看一下这10万用户中共同的关注的哪些UP主出现的次数最多。
代码的思路主要是从数据库中获取用户的名字,重复的次数越多说明越多的用户关注,然后我使用fate的一张图片作为词云的mask图片,最后生成词云图片。

最后一起来看一下词云图
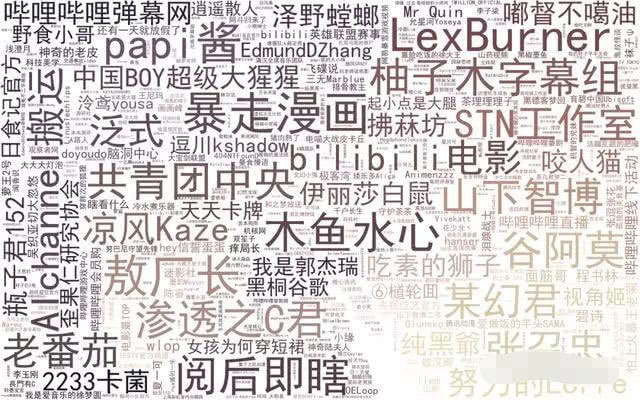
可以看出蕾丝,暴走漫画,木鱼水心,参透之C君,papi酱等B站大UP主都是热门关注。
Python可以做什么?
web开发和 爬虫是比较适合 零基础的
自动化运维 运维开发 和 自动化测试 是适合 已经在做运维和测试的人员
大数据 数据分析 这方面 是很需要专业的 专业性相对而言比较强
科学计算 一般都是科研人员 在用
机器学习 和 人工智能 首先 学历 要求高 其次 高数要求高 难度很大