详解python pandas 分组统计的方法
首先,看看本文所面向的应用场景:我们有一个数据集df,现在想统计数据中某一列每个元素的出现次数。这个在我们前面文章《如何画直方图》中已经介绍了方法,利用value_counts()就可以实现(具体回看文章)
但是,现在,我们考虑另外一个场景,我们假如要想统计其中两列元素出现次数呢?举个栗子:
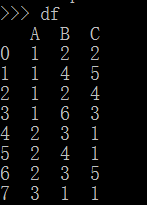
在df数据集中,如果我们想统计A、B两列的元素的出现情况,也就是说,得到如下表。
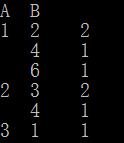
从上面的最后一列可以看到,在A、B两列中,1 2 出现了2次,1 4 出现1次 ,1 6出现1次,2 3出现了2次, 2 4 出现1次, 3 1出现了1次
具体实现的代码:
import pandas as pd
df=pd.DataFrame([[1,2,2],[1,4,5],[1,2,4],[1,6,3],[2,3,1],[2,4,1],[2,3,5],[3,1,1]],columns=['A','B','C'])
gp=df.groupby(by=['A','B'])
gp.size()
所以,如果想统计更多列,只要在groupby()中的by参数添加就可以,例如统计3列。
gp=df.groupby(by=['A','B','C'])
由gp.size()得到的是可以mulitiindex Series。
下面,要转化成DataFrame的结构。
newdf=gp.size()
newdf.reset_index(name='times')
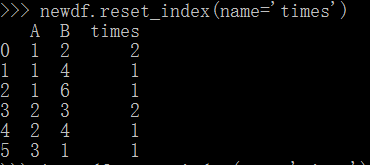
其中name中参数就是我们可以为最后一列添加新的名字,例如这里的“times”
这个时候newdf已经是DataFrame的类型了。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。