Python基于BeautifulSoup和requests实现的爬虫功能示例
本文实例讲述了Python基于BeautifulSoup和requests实现的爬虫功能。分享给大家供大家参考,具体如下:
爬取的目标网页:http://www.qianlima.com/zb/area_305/
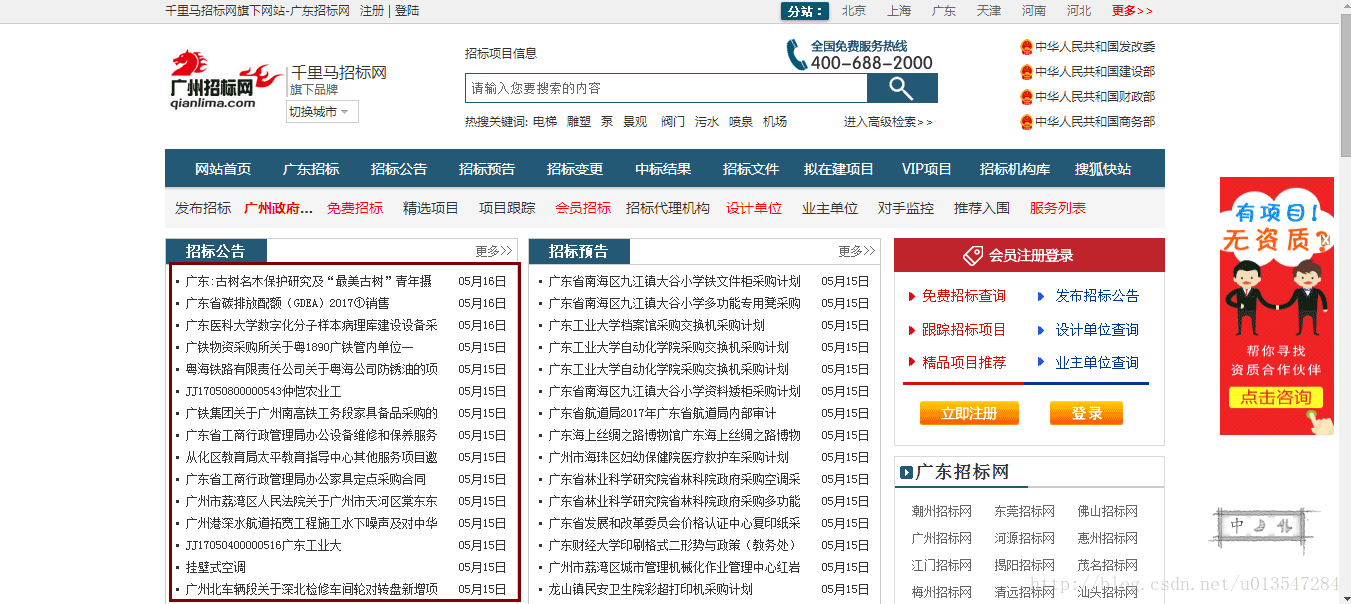
这是一个招投标网站,我们使用python脚本爬取红框中的信息,包括链接网址、链接名称、时间等三项内容。
使用到的Python库:BeautifulSoup、requests
代码如下:
# -*- coding:utf-8 -*-
import requests
from bs4 import BeautifulSoup
url = 'http://www.qianlima.com/zb/area_305/'
user_agent = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/45.0.2454.101 Safari/537.36'
headers = { 'User-Agent' : user_agent}
r = requests.get(url,headers=headers)#连接
content = r.text#获取内容,自动转码unicode
soup = BeautifulSoup(content,"lxml")
tags1 = soup.select('div .shixian_zhaobiao')
tag1 = tags1[0]
tag2 = tag1.find(name = 'dl')
tags2 = tag2.find_all(name = 'a')
tags3 = tag2.find_all(name = 'dd')
for tag in tags2:
 print tag.get('href')
 print tag.string
 print tag.next_element.next_element.string
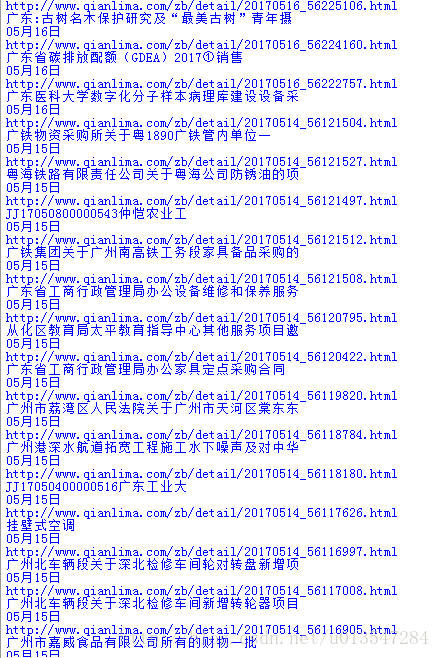
运行结果如下
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。