python3抓取中文网页的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了python3抓取中文网页的方法。分享给大家供大家参考。具体如下:

#! /usr/bin/python3.2
import sys
import urllib.request
req = urllib.request.Request('http://www.baidu.com')
response = urllib.request.urlopen(req)
the_page = response.read()
type = sys.getfilesystemencoding()
#转换成本地系统编码
print(the_page.decode(type))

希望本文所述对大家的Python程序设计有所帮助。
相关文章

用Python编写简单的微博爬虫

用Python编写简单的微博爬虫

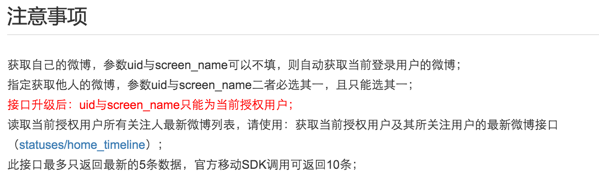
先说点题外话,我一开始想使用Sina Weibo API来获取微博内容,但后来发现新浪微博的API限制实在太多,大家感受一下: 只能获取当前授权的用户(就是自己),而且只能返回最新的...

Python爬虫PyQuery库基本用法入门教程

Python爬虫PyQuery库基本用法入门教程

本文实例讲述了Python爬虫PyQuery库基本用法。分享给大家供大家参考,具体如下: PyQuery库也是一个非常强大又灵活的网页解析库,如果你有前端开发经验的,都应该接触过jQue...

python抓取搜狗微信公众号文章

python抓取搜狗微信公众号文章

初学python,抓取搜狗微信公众号文章存入mysql mysql表: 代码: import requests import json import re import pymy...

Python实现抓取百度搜索结果页的网站标题信息

Python实现抓取百度搜索结果页的网站标题信息

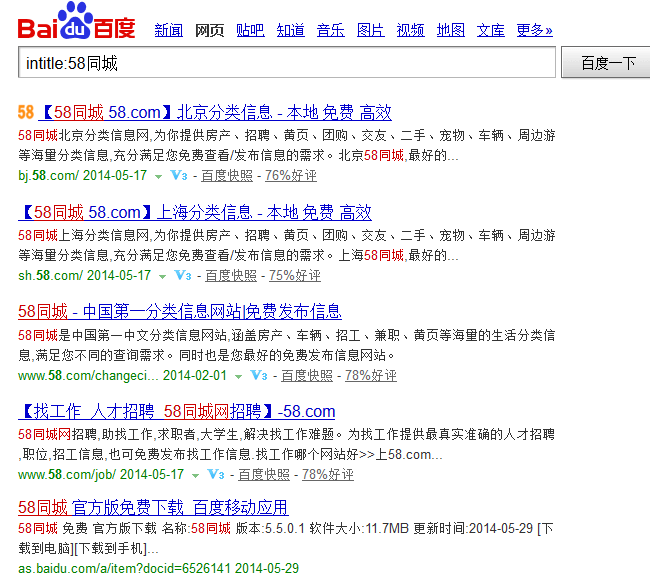
比如,你想采集标题中包含“58同城”的SERP结果,并过滤包含有“北京”或“厦门”等结果数据。 该Python脚本主要是实现以上功能。 其中,使用BeautifulSoup来解析HTM...

Python实现周期性抓取网页内容的方法

本文实例讲述了Python实现周期性抓取网页内容的方法。分享给大家供大家参考,具体如下: 1.使用sched模块可以周期性地执行指定函数 2.在周期性执行指定函数中抓取指定网页,并解析出...