Python Request爬取seo.chinaz.com百度权重网站的查询结果过程解析
一:脚本需求
利用Python3查询网站权重并自动存储在本地数据库(Mysql数据库)中,同时导出一份网站权重查询结果的EXCEL表格
数据库类型:MySql
数据库表单名称:website_weight
表单内容及表头设置:表头包含有id、main_url(即要查询的网站)、website_weight(网站权重)

要查询的网站:EXCEL表格

二:需求实现
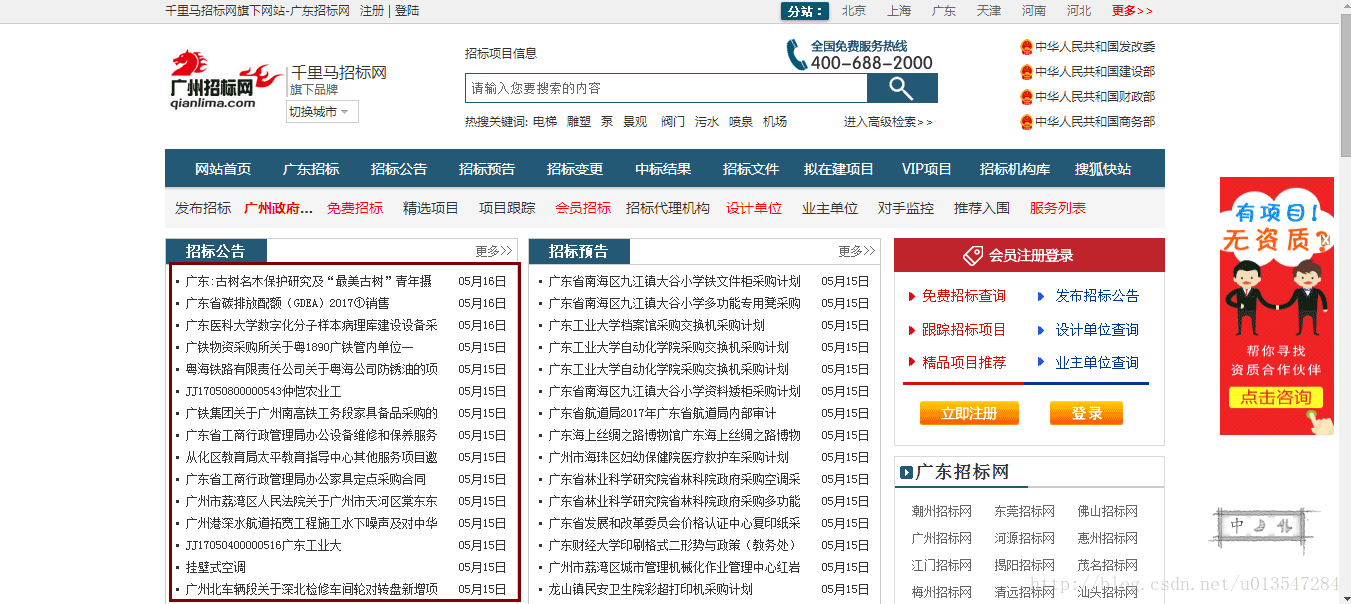
一:利用openpyxl模块解析excel文件,将查询的网站读取到一个列表中保存
# 解析excel文件,取出所有的url
def get_urls(file_path):
 wb = load_workbook(file_path)
 sheet = wb.active
 urls = []
 for cell in list(sheet.columns)[1]:
 if cell != sheet['B1']:
  urls.append(cell.value)
 return wb, urls
二:分析请求发送,伪造请求,取得HTML页面
# 伪造请求,取得html页面
def get_html(url):
 # 定义http的请求Header
 headers = {}
 # random.randint(1,99) 为了生成1到99之间的随机数,让UserAgent变的不同。
 headers[
 'User-Agent'] = "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537." + str(
 random.randint(1, 99))
 # Referer地址使用待查询的网址
 headers['Referer'] = "http://seo.chinaz.com/" + url + "/"
 html = ''
 try:
 html = requests.get("http://seo.chinaz.com/" + url + "/", headers=headers, timeout=5).text
 except Exception:
 pass
 return html
三:分析HTML页面,利用BeautifulSoup模块提取数据
# 利用BeautifulSoup模块从html页面中提取数据
def get_data(html, url):
 if not html:
 return url, 0
 soup = bs(html, "lxml")
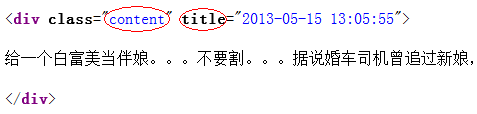
 p_tag = soup.select("p.ReLImgCenter")[0]
 src = p_tag.img.attrs["src"]
 regexp = re.compile(r'^http:.*?(\d).gif')
 br = regexp.findall(src)[0]
 return url, br
四:数据库连接配置,并获取游标
# 连接数据库
def get_connect():
 conn = pymysql.connect(
 host='127.0.0.1',
 port=3306,
 user='root',
 passwd='root',
 db='seotest',
 charset="utf8")
 # 获取游标对象
 cursor = conn.cursor()
 return conn, cursor
五:主程序逻辑编写
if __name__ == "__main__":
 #命令行执行脚本文件,获取excel文件路径
 file_path = sys.argv[1]
 #获取URL列表和excle工作簿
 wb, urls = get_urls(file_path)
 #获取数据库连接和游标
 conn, cursor = get_connect()
 #获取工作簿当前工作sheet
 sheet = wb.active
 #数据库插入语句
 sql_insert = '''insert into website_weight(main_url, website_weight) values (%s, %s)'''

 for row, url in enumerate(urls):
 if not url: continue
 html = get_html(url)
 data = get_data(html, url)
 # 插入数据到数据库
 cursor.execute(sql_insert, data)
 # 插入数据到Excel表中
 cell = sheet.cell(row=row + 2, column=3)
 cell.value = data[1]
 # 终端打印插入的数据
 print(data)
 conn.commit()
 conn.close()
 wb.save(file_path)
 wb.close()

# cmd命令:python3 F:\算法与结构\网站权重.py F:\website.xlsx
三:脚本运行及其实现结果
CMD执行

数据库:

excel文件写入:

以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。