python3 实现爬取TOP500的音乐信息并存储到mongoDB数据库中
爬取TOP500的音乐信息,包括排名情况、歌曲名、歌曲时间。
网页版酷狗不能手动翻页进行下一步的浏览,仔细观察第一页的URL:
http://www.kugou.com/yy/rank/home/1-8888.html
这里尝试将1改为2,再进行浏览,恰好是第二页的信息,再改为3,恰好是第三页的信息,多次尝试发现不同的数字即为不同的页面。因此只需更改home/后面的数字即可。由于每页显示的为22首歌曲,所以总共需要23个URL。
import requests
from bs4 import BeautifulSoup
from time import sleep
import pymongo
#连接数据库
client = pymongo.MongoClient(‘localhost',27017)
mydb = client[‘yourdb']
#创建数据库
musicTop = mydb[‘musicTop']

#使用header是用于伪装为浏览器,让爬虫更稳定
Headers = {
‘User-Agent': ‘Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'
}
#定义获取信息的函数
def get_info(url):
wd_data = requests.get(url,headers=Headers)
soup = BeautifulSoup(wd_data.text,‘lxml')
#获取排名情况
ranks = soup.select(‘span.pc_temp_num')
#获取标题
titles = soup.select(‘div.pc_temp_songlist > ul > li > a')
#获取时间
times = soup.select(‘span.pc_temp_tips_r > span')
for rank,title,time in zip(ranks,titles,times):
data = {
‘rank':rank.get_text().strip(),
‘singer':title.get_text(),
‘song':title.get_text(),
‘time':time.get_text().strip()
}
musicTop.insert_one(data) #存入数据库中
if name == ‘main':
urls = [‘http://www.kugou.com/yy/rank/home/{}-8888.html'.format(number) for number in range(1,24)]
for url in urls:
get_info(url)
sleep(2)
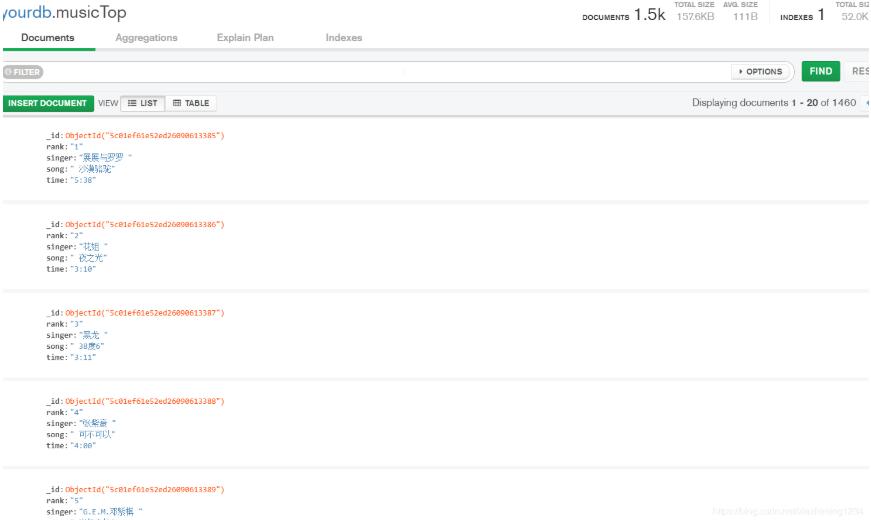
运行后,爬取的数据在mongoDB数据库中显示如下:
以上这篇python3 实现爬取TOP500的音乐信息并存储到mongoDB数据库中就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。