通过python爬虫赚钱的方法

yipeiwu_com7年前Python爬虫

(1)在校大学生。最好是数学或计算机相关专业,编程能力还可以的话,稍微看一下爬虫知识,主要涉及一门语言的爬虫库、html解析、内容存储等,复杂的还需要了解URL排重、模拟登录、验证码识别、多线程、代理、移动端抓取等。由于在校学生的工程经验比较少,建议找一些少量数据抓取的项目,而不要去接一些监控类的项目、或大规模抓取的项目。慢慢来,步子不要迈太大。

(2)在职人员。如果你本身就是爬虫工程师,挣钱很简单。如果你不是,也不要紧。只要是做IT的,稍微学习一下爬虫应该不难。在职人员的优势是熟悉项目开发流程,工程经验丰富,能对一个任务的难度、时间、花费进行合理评估。可以尝试去找一些大规模抓取任务、监控任务、移动端模拟登录并抓取任务等,收益想对可观一些。

总结:以上就是学习python爬虫相关的赚钱思路和方法,感谢大家对【听图阁-专注于Python设计】的支持。
相关文章

python 爬取学信网登录页面的例子

python 爬取学信网登录页面的例子

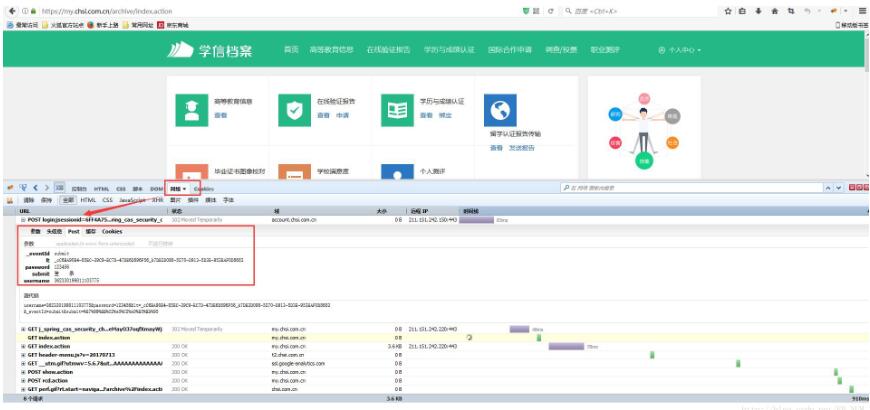
我们以学信网为例爬取个人信息 **如果看不清楚 按照以下步骤:** 1.火狐为例 打开需要登录的网页–> F12 开发者模式 (鼠标右击,点击检查元素)–点击网络 –>需要...

Python爬虫小技巧之伪造随机的User-Agent

前言 不管是做开发还是做过网站的朋友们,应该对于User Agent一点都不陌生,User Agent 中文名为用户代理,简称 UA,它是一个特殊字符串头,使得服务器能够识别客户使用的操...

python网络爬虫采集联想词示例

python爬虫_采集联想词代码 复制代码 代码如下:#coding:utf-8import urllib2import urllibimport reimport timefrom r...

Python3使用requests包抓取并保存网页源码的方法

本文实例讲述了Python3使用requests包抓取并保存网页源码的方法。分享给大家供大家参考,具体如下: 使用Python 3的requests模块抓取网页源码并保存到文件示例:...

python打造爬虫代理池过程解析

最近在使用爬虫爬取数据时,经常会返回403代码,大致意思是该IP访问过于频繁,被限制访问。限制IP访问网站最常用的反爬手段了,其实破解也很容易,就是在爬取网站是使用代理即可,这个IP被限...